





有一款外观平平无奇的终端,能响应你输入的 ls、cd、mkdir,甚至支持打开 vim 编辑文件、运行 python 脚本、启动 tmux 多窗口会话——所有交互体验与真实系统几乎完全一致。但它的本质却令人咋舌:背后既无 linux 内核,也无真实文件系统,更未实际执行任何一条命令;屏幕上呈现的一切,全由 ai 实时生成。这个名为 worldtui 的项目,其核心目标只有一个:训练模型学会“即兴表演”。
开发者 Simon Edwardsson 以 Qwen2.5-Coder-0.5B 为基座模型,微调出一个参数量约 3.6 亿、体积达 716MB 的轻量级模型,再经 int4 量化压缩至 208MB,轻松可在本地设备上运行。它的运行机制极为简洁:AI 并不执行任何程序,仅依据你键入的指令,预测终端下一帧应显示的内容。你让它创建文件,它就“假装”创建成功;你让它读取文件,它便努力复现此前“写入”的内容;你进入 Vim 模式,它立刻切换角色继续演绎;就连 Python 解释器的交互提示和 tmux 的多窗格布局,它也能惟妙惟肖地模拟出来。简言之,只要它演得足够逼真,你就很难察觉异常。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
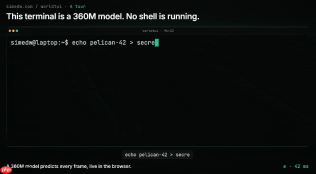
更神奇的是,这位“戏精”还具备短期记忆能力。你在 Vim 中编辑并保存的内容,稍后再次打开仍能完整复现——因为这些信息被隐式保留在上下文之中。当然,一旦开启全新终端会话,所有记忆即刻清零——毕竟自始至终,没有任何真实文件被写入磁盘。

这套“演技”并非凭空而来,而是经过严谨训练所得。开发者首先在 Docker 容器中部署真实的 Linux 环境,运行 Bash、Vim、Python 和 tmux,并随机生成用户名、目录结构、测试文件及操作任务;接着通过脚本模拟人类操作行为,逐字符输入命令,还特意引入 1.2% 的打字错误,同时全程捕获每次按键后终端界面的真实变化。借助该方法,共采集了 33.6 万段操作序列、总计约 20 亿 Token 的高质量训练数据,用于对原始 0.5B 模型进行监督微调,使其掌握“根据当前输入+历史画面推断下一行输出”的能力。当模型预测出现偏差时,系统会自动提取真实终端反馈构造纠错样本,引导模型自我修正、降低连续交互中的逻辑断裂概率。最终,通过行级并行预测、词表裁剪与 4-bit 量化等优化手段,将模型压缩至约 208MB,整套训练耗时 75 小时,全程运行于单张 NVIDIA RTX 4090 显卡之上。
当然,模型终究难逃穿帮时刻。面对复杂嵌套命令,输出常显混乱;文件内容可能在不经意间悄然变更;数学计算结果亦未必准确——毕竟它从未真正调用过 shell 或解释器。对普通用户而言,该项目虽暂无直接实用价值,却提供了一个极具启发性的范式:让大模型观察真实软件的操作过程,再学习模仿其行为模式。开发者已明确表示,将尽快开源模型权重并开放下载;目前在线体验需手动下载约 208MB 模型文件,推荐使用桌面浏览器访问。只是请务必谨记:这一切从头到尾皆为虚构,切勿沉浸太深。


