





【php中文网快讯】据 xiaomi mimo 官方消息,小米 mimo-v3 核心架构 hysparse2 在初代 hysparse 基础上完成关键演进,全面强化 kv 共享策略与稀疏选择粒度,显著提升模型在长上下文场景下的处理效率与检索精度。该架构专为长程多轮 agent 任务设计,实现更轻量的 prefill 计算、更紧凑的 kv cache 占用,以及更强健的长距离信息定位能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
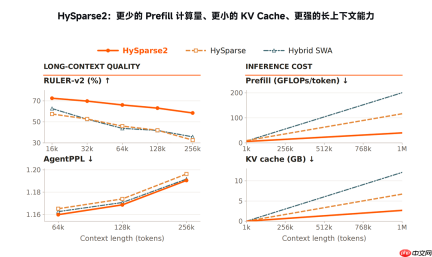 此前,MiMo-V2 系列采用 Hybrid SWA 混合注意力机制,融合全注意力(Full Attention)与滑动窗口注意力(Sliding Window Attention),在保障建模能力的前提下优化训练与推理开销。在持续迭代 V2 系列的同时,面向 MiMo-V3 的底层架构探索同步推进,HySparse 即为该技术路线的首个落地成果,而 HySparse2 则是其深度升级版本。
小米 MiMo 大模型负责人罗福莉近日公开确认,MiMo-V3 将搭载全新架构 HySparse2,核心目标直指降低 Prefill 阶段资源消耗、压缩 KV 缓存体积、增强跨轮次长历史中的语义检索准确性。
实测数据显示:在 100 万 Token 超长上下文场景下,HySparse2 相较前代 Hybrid SWA 方案,Prefill 计算量(FLOPs)下降达 5.02 倍;KV 缓存占用由约 12.09GB 缩减至 2.69GB,降幅达 4.5 倍;同时在 MRCRv2、RULER-v2 等权威长文本理解基准上得分提升,并在 AgentPPL、LongPPL 等面向智能体行为建模的关键指标中表现更优。
罗福莉指出,Agent 推理是一种高度特化的计算负载——单次工具调用指令可能仅含数十 token,但其返回的网页快照、执行日志或代码文件却常达数万甚至数十万 token。随着交互轮次增加,上下文持续膨胀,Prefill 算力压力、显存缓存瓶颈与长跨度证据召回精度三者共同构成性能天花板。

小米/米家智能家居设备控制。通过MCP Server工具控制家中设备,包括灯、空气净化器、电暖气、空调、风扇、扫地机器人、窗帘等。触发场景:用户提到智能家居控制指令,如"把灯关掉"、"开空调"、"净化器调到睡眠模式"、"客厅太暗了"、"家里空气不好"等。即使未明确提及"小米"或"米家",只要涉及家居设备控制即可触发。
为此,HySparse2 引入 KV 桥接(KV Bridging)机制,借鉴 YOCO 架构思想:Cross-Decoder 中的 Full Attention 层直接基于 Self-Decoder 对应层输出的隐藏状态生成自身 K/V,无需等待逐层前向传播;同时支持 KV 重用(KV Reuse):每个 HybridBlock 内,后续 Sparse Attention 层复用前置 Full Attention 层已计算出的 KV Cache 及注意力重要位置索引,避免重复构建。
此外,两项关键改进同步落地:一是将稀疏选择粒度由块级(block-level)升级为 token 级(token-level),使有限的注意力预算可精准分配至分散于多轮对话、工具响应及代码片段中的关键语义单元;二是取消独立 SWA 分支,改用“强制保留最近 128 token + 窗外全局采样 1024 token”机制,使局部与全局 token 统一共享同一套 KV 缓存结构。正因 Cross-Decoder 所需全部 KV 均源自 Self-Decoder,Prefill 过程可在 Self-Decoder 计算完毕后即时终止。
值得一提的是,小米已于近期正式发布并开源 Xiaomi MiMo-V2.6 系列模型,涵盖 Pro 与 Flash 两款原生全模态大模型(详情参见 PHP 中文网此前报道:《登顶全球开源大模型第一!小米发布并开源 MiMo-V2.6 系列》)。官方强调,V2.6 是 RSI(Recursive Self-Improvement)递归自我改进范式的重要实践,依托强化学习算力规模扩展与闭环反馈机制,持续拓展模型能力边界。






