






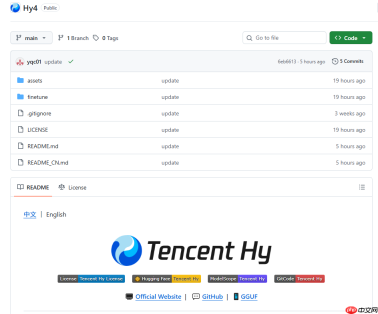
11 月 20 日,腾讯混元团队正式将 hy4 大模型的权重发布至 github、hugging face、modelscope 和 gitcode 四大平台,开发者可自由下载并本地部署。至此,混元 llm 系列实现全量开源——hy3 preview、hy3、hy4 preview、hy4、hy4 flash 全部齐备,家族阵容完整。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
770B 旗舰级模型,上下文突破百万 Token
Hy4 正式版于 11 月 4 日首发,本次开源兑现了此前承诺。该模型采用 MoE(Mixture of Experts)混合专家架构,总参数量达 770B,每 token 激活参数约 49B,上下文长度支持超 100 万 Token。同期开源的还有高性价比版本 Hy4 flash:总参数量为 224B(含 64B Engram 参数),每 token 激活约 12B,支持多模态输入及 100 万 token 上下文,其 API 定价显著低于旗舰版。Hy4 与 Hy4 preview 均遵循 Apache 2.0 开源许可证,允许商用、二次开发与定制化修改,无额外限制。
训练数据聚焦“防御性”方向
值得关注的是,随模型同步公开的安全评估卡片(System Card)。官方披露,Hy4 的训练数据在网络安全相关领域严格限定于 PoC 生成、漏洞修复等防御型内容,明确排除漏洞利用、逆向工程、渗透测试等攻击性数据;经腾讯玄武实验室与科恩实验室联合安全审计,未检出明显进攻性能力风险。在模型权重全面开放之际仍坚持此数据边界,相当于先提交一份详实的“安全体检报告”,再向全球开发者敞开协作之门。
github:https://www.php.cn/link/62c8aa75297f642caa3a0d552b0788d1













