






这九个预发布构建分别涉及服务器参数与调度、语音模型支持,以及特定计算后端的修复和优化。判断它们与现有任务是否相关,关键在于模型、硬件和请求条件,而不是只比较构建号大小;这些记录不代表正式稳定版,也没有给出所有模型通用的性能提升结论。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
llama.cpp 这九个预发布构建分别改变了什么?
本次涉及的完整构建号为 b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498。官方发行记录均标有 Pre-release,并提供按系统、架构和后端区分的分发资产。下面按实际问题分类说明,适合用于判断相关性,不是已经在读者设备上完成的测试报告。
服务器:参数冲突与调度状态是两类问题
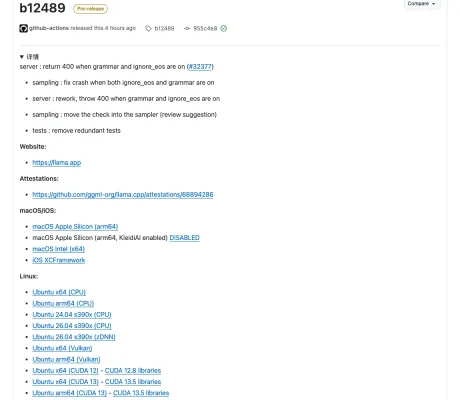
b12489:处理 grammar 与 ignore_eos 同时启用的情况。变更包含采样侧的崩溃修复,服务器对这一组合返回 HTTP 400,并把相关检查移入采样器。这意味着该组合被明确拒绝,而不是两个选项从此可以一起使用。只有遇到这类请求条件时,这条记录才直接相关。
b12498:针对服务器 slot_sched 中 LoRA 与 recurrent 相关的调度问题修复。它与 b12489 的参数组合检查属于不同位置,不能混为同一项修复。发行说明还解释了混合 SWA 检查点测试为什么改为每个 ubatch 一个 token:缓存与非缓存路径的分批方式不同,会让 CUDA 内核路径和接近的概率排序出现差异。
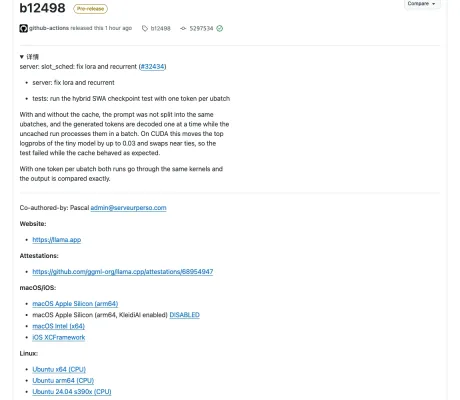
这一测试调整的作用是让两条测试路径在相同内核条件下进行精确输出比较。它没有宣布所有 CUDA 结果都逐位相同,也不能据此推导缓存原先必然失效。调度修复与测试比较条件需要分别理解。
语音:三种模型支持不要互相套用
b12491:mtmd 增加 Qwen3-TTS 的 ICL/reference mode 支持。相关修改还涉及正确性与转录信息附着。它针对指定模型的参考模式,不等同于所有语音模型获得同样的参考能力。
b12494:mtmd 增加 Kokoro TTS 支持。该条目的修改涉及 G2P 模板、文本规范化相关说明、模板作用域查找及批处理 API 迁移等。这里的支持对象是 Kokoro;不能把这份变更当成 Qwen3-TTS 的使用参数说明。

b12497:mtmd 增加 tiny-voca 支持并改进 G2P。三条记录共同指向语音相关能力,但模型资产、输入形式和适用路径仍各有边界;“支持某模型”并不保证任意权重文件都可直接使用。
计算路径:模型、量化类型和 GPU 架构都有限定
b12490:修复 qwen4exp 中 n-gram 表缩放引起的计算图重新分配,使用 ggml_scale 应用缩放,并在加载后读取一次缩放值。受影响的是这一特定模型路径,不应概括成所有 Qwen 模型的通用修复。
b12492:OpenCL 增加 A7 Q5_K non-MoE 二进制内核。后端、量化类型与 non-MoE 条件都是这条变更的重要限定,不能扩展为所有 OpenCL 模型或所有量化格式都已优化。
b12493:CUDA 让 F32 卷积核走 implicit GEMM conv2d 路径。其说明是先在池缓冲区把 F32 卷积核转换为 F16,再沿快速路径以 F32 累加;因此“输入卷积核是 F32”不等于中间计算全过程都保留 F32 操作数。实际收益仍取决于对应卷积任务。
b12496:HIP 为 AMD GCN 调整 stream_k 算法和 MMQ 配置,使相应路径使用 stream_k。记录还说明 CDNA 测试没有改善,因此不能把 GCN 的改动宣传为全部 AMD GPU 的一致提速。
源码提交、构建标签与可下载包如何区分?
发行标签对应源码修订,发布资产则是该构建下列出的具体分发文件。源码中出现某项支持,并不能单独证明每个预编译包都启用了它;资产列表中的操作系统、CPU 架构和后端限定仍然有效。源码归档与预编译程序包也不是同一种交付物。
因此,这组构建更适合按问题对照:服务请求被拒绝对应 b12489,服务器调度对应 b12498,语音需求对应三个具体模型条目,计算优化则对应具体模型或后端条件。官方变更能说明修复目标和实现方向,但无法代替目标机器、模型文件与业务输入上的兼容性结果。













