fireworks ai 最近推出了 firerouter with opus,这是业界首款具备缓存感知能力的智能路由器,专为 claude opus 系列模型深度优化,并首次以独立路由模型的形式作为 serverless 接口对外提供。
经过逾一个月的内部 A/B 对比测试,该方案在执行编码类任务时,准确率达到了纯 Opus 方案的 98.1%,同时将整体成本压低了 57%。
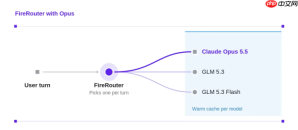
FireRouter 的核心机制在于:在每一次用户交互轮次中,动态评估候选模型池中各模型对当前请求的适配度,精确估算每个模型的推理开销(含提示缓存相关成本),并综合权衡“切换模型所节省的费用”与“可能丢失缓存收益”之间的利弊,最终选择在效果与成本之间实现最优平衡的模型进行响应。当前支持的模型池包括 Claude Opus5.5、GLM5.3 和 GLM5.3Flash,未来将随新模型上线持续扩展和更新。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
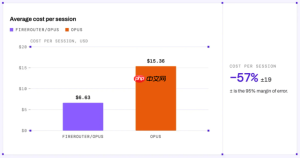
测试数据源自 Fireworks AI 内部真实的编码流量,所有会话被随机划分至 FireRouter with Opus 实验组或仅调用 Opus 的对照组,两组在工作负载分布与用户行为上完全一致。结果显示,单次会话平均成本由 15.36 美元下降至 6.63 美元,降幅达 57%(置信区间为 ±19 个百分点,95% 水平)。在准确性方面,FireRouter with Opus 在人工评分轮次中获得 78.7 分,而纯 Opus 组为 80.2 分,二者差距仅为 1.5 个百分点(±1.3),即其准确率相当于 Opus 基线的 98.1%。

通过本地 Codex 或 OpenClaw OAuth 凭证直接调用 ChatGPT/Codex Responses 的 image_generation 工具来生成或编辑光栅图像,然后保存
缓存命中率方面,FireRouter with Opus 达到 94.2%,略低于纯 Opus 的 97.8%,相差 3.6 个百分点。Fireworks AI 指出,这一小幅下降是设计上的主动权衡——由于大量常规编码任务可由开源模型高效完成,缓存感知路由策略通过将简单请求导向更经济的模型,显著拉低了总体开销。
目前,FireRouter with Opus 已接入 Claude Code、Codex、Cursor IDE 等主流开发工具链。用户只需运行两条命令即可快速启用:fireconnect login 和 fireconnect claude --model firerouter/opus。Fireworks AI 表示,其 Fireworks Nexus 解决方案的目标是帮助工程团队无缝集成前沿开源模型至现有技术栈,在不降低响应速度与输出质量的前提下,将模型使用成本削减一半。