多轮提问需有节奏地收窄范围、校准方向、激活深度推理:每轮以“角色+目标”开头,主动压缩历史,用结构化指令替代模糊表达,善用缓存前缀提升效率。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
多轮提问不是简单地“接着问”,而是有节奏地收窄范围、校准方向、激活模型的深度推理能力。GPT-6 Astra 的长上下文和 agent 式行为,让它天然适合深挖,但前提是每一轮提问都得“带钩子”——既要承接前序逻辑,又要明确触发下一步动作。
用角色+目标锚定每次追问
别让模型靠猜来理解你想要什么细节。每轮新问题开头,直接声明角色和本次目标,比如:
- “你现在是资深电路工程师,请聚焦分析图中这个运放反馈回路的相位裕度问题。”
- “你现在是合规审计员,请只提取合同第7.2条隐含的三项履约风险点,不扩展解释。”
这种写法能绕过模型默认的泛化倾向,避免它把精力花在无关背景上,Token 也省在刀刃上。
主动压缩历史,别让旧信息拖累新轮次
GPT-6 每次请求都会重算全部历史消息。如果你已聊了10轮,第11轮只改了一个参数,但系统仍把前10轮全塞进去,成本就翻倍了。实操建议:
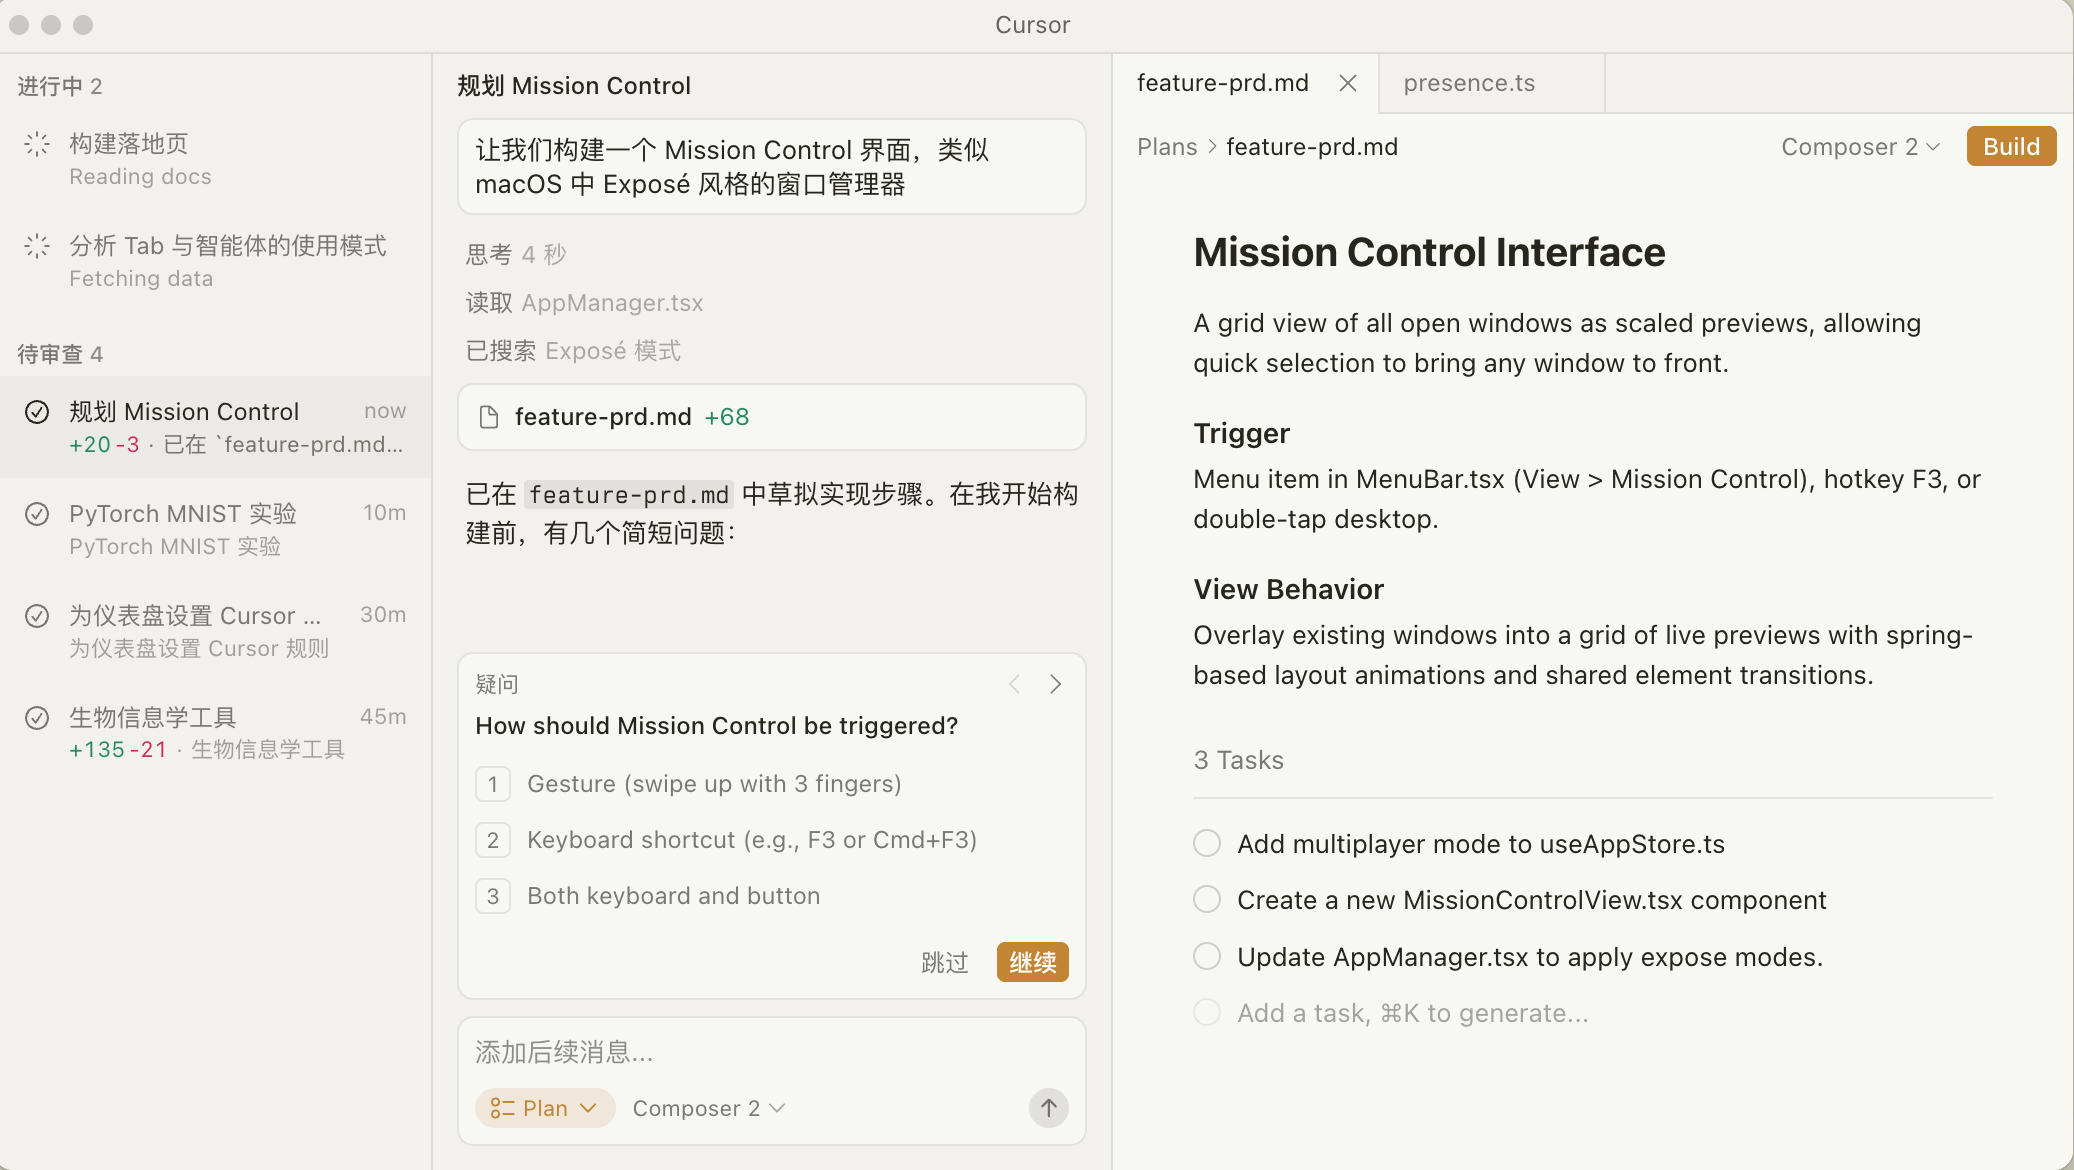
Cursor 2.4
下载
Agents 正在你的整个代码库中处理越来越复杂、运行时间更长的任务。本次版本引入了新的 agent 框架改进,以实现更好的上下文管理,并在编辑器和 CLI 中带来了许多提升使用体验的修复。
- 关键结论单独摘出,作为下一轮的“前置摘要”插入,替代原始长对话;
- 用「→」或「|」符号手动分隔不同阶段,例如:“需求确认|方案设计|接口验证”,模型更容易识别阶段跃迁;
- 第三方工具(如Cursor、Continue.dev)支持自动历史截断,可设为“仅保留最近3轮+摘要块”。
用结构化指令替代模糊追问
“再详细一点”“说得具体些”这类表达对 GPT-6 Astra 效果很弱——它会自己决定什么叫“详细”,结果常是堆砌冗余描述。换成可执行指令更有效:
- “请列出这三类错误在日志中的5种典型时间戳模式,并标注每种对应的线程ID特征。”
- “对比表格:左列是当前方案,右列是去掉缓存层后的性能变化,字段包括QPS、P99延迟、内存占用。”
- “生成3个反例,每个必须违反原文第4段定义的‘强一致性’条件,且能被监控系统直接捕获。”
结构越明确,模型越少做无效试探,输出也更贴近你要的“细节粒度”。
善用缓存前缀,让重复上下文零成本复用
当你需要围绕同一份材料反复提问(比如审一份PDF合同),务必保证每次请求的开头1024 token 完全一致——这是触发提示缓存的最低门槛。操作要点:
- 把文档标题、版本号、页码范围、核心条款编号等固定信息,统一放在每轮提问最前面;
- 变动部分(你的新问题)严格放在固定块之后,中间不插说明性文字;
- 如果用 API,开启 prompt_caching 并监控 hit_rate,命中率超80%时,后续轮次输入成本可压到原来的1/10。