





中国电信于9月17日正式发布新一代星辰大模型——xing4.0-29b-a4b。该模型总参数量达290亿,激活参数仅40亿,原生支持256k上下文长度,并可灵活扩展至512k,系国内首个从训练芯片到推理部署全链路自主可控、且专为复杂工程场景深度优化的百亿级大语言模型。
最核心的亮点在于“全栈国产”这一完整闭环能力。官方实现了端到端自主:昇腾AI芯片承担训练任务,国产深度学习框架完成适配,模型架构完全自研,生态全面开源——从底层算力基础设施,到上层开发工具链,全程不依赖任何境外技术组件。在算力领域频频遭遇外部制约的当下,这种对整条技术路径的自主掌控力,远比单纯追求参数规模更具战略价值。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
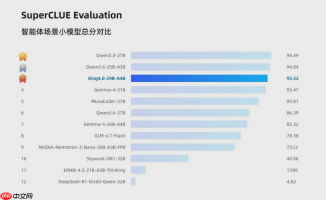
其实际性能表现同样扎实。在SuperCLUE综合评测中,Xing4.0-29B-A4B的智能体(Agent)能力得分高达93.52,位列全国第三,与排名前两位的Qwen系列头部模型分差均不足1分,印证了这款“轻量化”模型在真实工程任务中的实战水准已稳居第一梯队前列。

监控 OpenClaw GitHub 版本更新,获取最新版本发布说明,翻译成中文, 并推送到 Telegram 和 Feishu。用于:(1) 定时检查版本更新 (2) 推送版本更新通知 (3) 生成中文版发布说明
对开发者尤为友好的是其极低的部署门槛。经4-bit量化压缩后,显存占用仅为15GB,相较FP16格式节省约75%资源,这意味着一块配备24GB显存的消费级GPU(如RTX 3090或RTX 4090),即可本地运行长上下文推理任务——无需集群服务器,也无需租赁云端算力卡,个人开发者及中小型团队均可轻松上手。
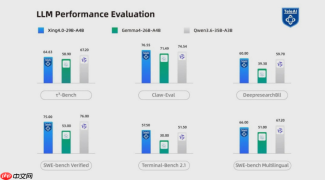
开源策略亦保持高度开放。该模型延续星辰系列一贯的开源路线,全面兼容主流生态:微调阶段支持LLaMA-Factory、MindFormers;推理层面适配SGLang、vLLM、KTransformers;在Agent框架方面,更针对OpenCode、Claude Code、OpenClaw、Hermes等主流方案完成定向优化,并统一规范各平台输入输出接口。目前模型已陆续登陆HuggingFace、GitHub、魔搭(ModelScope)、Gitee、魔乐等多个开源社区,开发者可随时下载、调试、部署。一个由国产算力训练而成的智能体大模型,正以完全开放的姿态,跻身全球开源AI生态的核心竞技场。





