





阶跃星辰于9月15日正式推出全新一代 stepaudio3 系列语音大模型。本次发布的模型体系涵盖五款核心产品:stepaudio3realtime、stepaudio3asr、stepaudio3tts、stepaudio3gen 以及 stepaudio3music。多款模型在国际权威评测平台 artificial analysis 的多项榜单中斩获全球榜首,彰显其技术领先性。目前,全部五款模型均已上线阶跃星辰开放平台,分别聚焦于真人级语音合成、端到端音频内容生成、低延迟实时语音交互、高鲁棒性语音理解,以及专业级音乐创作五大关键应用方向。
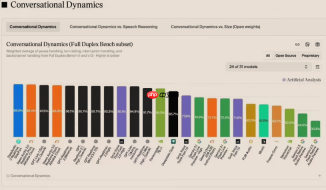
在实时语音交互方向,StepAudio3Realtime 原生支持全双工实时对话架构。该模型在 Artificial Analysis Conversational Dynamics 榜单中以98.9%的综合性能得分荣登全球首位;同时,在 Artificial Analysis Speech Reasoning 榜单中,其语音逻辑推理准确率达99.7%,同样位居世界第一。模型不仅能精准捕捉对话节奏、响应用户即时打断与多轮连续反馈,还可同步解析语义、语气、情绪状态、副语言特征(如叹息、笑声、停顿)及环境声信号。更进一步,它实现了语音识别、语义推理与语音合成的并行处理,并支持工具调用(Tool Call)与长周期任务的异步执行,彻底规避会话卡顿与响应延迟。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
语音识别方面,StepAudio3ASR 创新融合高保真声学建模与大语言模型的知识驱动能力,突破传统 ASR 单一转录范式。模型全面覆盖中文、英文、主流方言、中英混合表达、超长语音片段及垂直行业场景,在医疗问诊、法律庭审、金融客服、智能座舱、编程辅助等专业领域表现卓越。即使面对低声细语、超高语速、含混连读、歌唱片段或强背景音乐干扰等极端条件,仍保持极强鲁棒性。其非流式识别词错误率(WER)低至1.7%,与全球顶尖模型并列第一。

语音合成方向,StepAudio3TTS 是专为实时交互优化的真人级语音生成模型。它在音色质感、语调起伏、节奏张力与呼吸停顿等维度高度复刻人类自然口语规律,不仅能真实还原迟疑、结巴、重复、自我修正、轻笑等副语言细节,还可依据上下文语义自动适配情绪色彩与表达强度。依托流式生成引擎,模型实现边生成边播放,显著降低端到端延迟。
面向音频内容一体化生成,StepAudio3Gen 重构了传统音频生产流程——告别分轨录制、手动剪辑与后期混音的繁复工序。用户仅需输入自然语言指令与可选参考音频,即可一次性生成包含人声、拟音、环境声与背景音乐的完整音频成品。模型支持对角色音色、语速风格、情感倾向、地域口音及各类副语言行为进行精细化调控,并允许用户精确指定对白起止、音效触发时刻与BGM铺排顺序,深度参与声音叙事的结构设计与时序编排。
在音乐生成领域,StepAudio3Music 不仅支持从零开始的全自动作曲,还首创基于 ABC 记谱法的多轮可控交互创作模式。用户可通过歌词文本、清唱录音、参考曲目或标准乐谱输入启动创作,并使用自然语言灵活调节曲风、人声类型、旋律走向、节拍律动、乐器编配及情绪基调。模型对歌曲整体结构、段落间旋律演进逻辑与能量曲线变化进行了深度建模;尤其在清唱配乐场景下,仅凭一段无伴奏人声,即可智能补全和声织体、节奏骨架、器乐层叠与完整编曲,真正嵌入专业音乐制作工作流。


