





pandas官方博客已经放出3.0版本的更新说明,这个常用的数据分析库正式进入新的主版本迭代周期。官方称这是大家盼了很久的大版本,核心改动点有四个:默认字符串类型、copy-on-write机制、datetime类数据的默认精度调整,还有新增的pd.col语法。不管是做数据分析还是数据工程,这次升级都不是普通的维护更新——它会直接改变字符串列的推断规则、视图和拷贝的行为预期,不少旧代码里判断dtype的逻辑可能直接失效。
来源:Pandas 官方博客
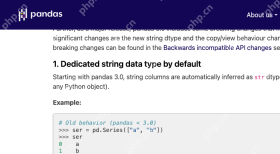
官方明确提到,Pandas 3.0默认会把字符串列推断为新的str dtype,不再沿用过去常见的NumPy object dtype。这个改动对库作者和内部数据平台的开发团队影响尤其大。很多旧代码都是靠判断dtype等于object来识别字符串列,升级后要是没提前适配,很容易出现分支逻辑不命中、测试快照对不上、类型检查结果异常的问题。官方同时强调,这个改动让字符串的类型语义更明确,不用再纠结“object类型里到底混了什么数据”的不确定性。
来源:Pandas 官方博客
Copy-on-Write也是3.0里对业务代码影响很大的改动。官方说明里称新机制能让copy和view的行为更统一,目标是彻底解决过去SettingWithCopyWarning频繁出现的歧义问题。对日常写分析脚本的人来说,之前常用的链式赋值、切片后直接修改、复用中间对象的写法,升级后都要重新跑测试确认效果;对跑在生产环境的数据管道来说,别装完新版本就直接上线,一定要提前排查有没有依赖旧版本副作用的逻辑。
Pandas 3.0还调整了datetime类数据的默认分辨率,不再像以前那样统一默认纳秒,通常会自动采用微秒,或者直接沿用输入自身的分辨率。官方这么改的目的是避免之前经常碰到的日期越界问题,对处理历史日期、远期日期和跨系统时间数据的项目有实际意义。整体看下来,3.0的核心方向是把过去多个版本积累的零散行为差异一次性收拢,换来更清晰的类型和内存语义。
信源说明:本文依据Pandas官方3.0发布博客和官方发布说明撰写;具体兼容性仍以项目实测、依赖版本和官方迁移说明为准。


