





近日,界面财联社旗下大模型科技公司财跃星辰携手上海交通大学安泰经济与管理学院花成副教授团队,正式开源推出全新金融推理大模型 alpha-r1。该模型以8b参数为基座,依托原创“语义门控”推理机制与两阶段强化学习训练框架,在金融推理任务的样本外评测中显著超越通用大模型及传统量化方法。
在真实投研实践中,当前主流方案普遍存在两大瓶颈:其一,通用大模型虽可解析海量财经文本,却难以将非结构化信息转化为可执行的投资逻辑,形同熟读医书而无法诊疗;其二,传统资产配置策略高度依赖历史统计规律,缺乏对经济机理的理解与动态适配能力,既无法解释策略有效性来源,亦难判断其失效边界。Alpha-R1 的核心使命,正是弥合“理解市场”与“驾驭市场”之间的鸿沟,使AI不仅能实时解构复杂市场语境,更能据此动态甄选、组合并解释最适配当下环境的配置逻辑。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
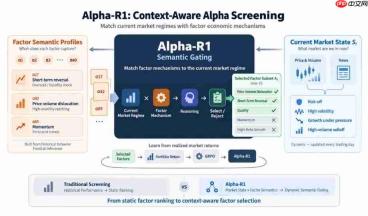
为达成这一目标,Alpha-R1首创“语义门控”推理范式。每次决策前,模型融合实时行情数据与决策窗口期内的财经新闻,生成高保真“当前市场状态画像”。随后,系统对数百条候选配置策略所附带的“经济逻辑说明书”进行细粒度语义比对,仅保留逻辑前提与当前市场状态高度一致的少数策略,其余全部过滤,并据此指导股票池权重分配。该机制彻底摒弃了策略平均加权的粗放模式,实现“因时制宜、按需启策”的智能决策闭环。
在模型训练层面,Alpha-R1构建了严密的两阶段进阶路径:第一阶段采用数值驱动方式初步筛选出具备潜在价值的策略集合;第二阶段则由模型自身作为“语义面试官”,依据经济逻辑与市场状态的匹配度完成深度复筛;此后,引入 GRPO(Group Relative Policy Optimization)强化学习进行端到端优化,其奖励信号直接来源于全真模拟交易环境下的实际收益表现——相当于以实盘绩效为唯一考官,持续迭代打磨决策能力。消融实验表明,若移除强化学习模块,标普500任务的模拟年化收益将从47.87%断崖式下滑至12.85%,印证其动态市场感知与决策能力确为训练所得(历史回测结果,不构成投资建议)。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
研究团队基于2025年全年12个月、训练阶段完全未接触的真实行情开展样本外全真模拟评测。结果显示:当前性能最强的通用大模型 DeepSeek-R1 在标普500与沪深300任务中分别仅实现21.94% 和14.66% 的模拟年化收益;而 PCA、XGBoost、LightGBM、PPO、DDPG、TD3、SAC 等主流统计与强化学习方法均明显落后。尤为突出的是,在罗素2000与中证1000这两类训练中从未覆盖的全新股票池上,Alpha-R1 依然展现出卓越的跨市场泛化能力。
为增强可解释性与可信度,论文附录完整还原了2025年4月9日美股恐慌抛售日的关键决策过程。当日,Alpha-R1精准识别市场状态为“恐慌主导、短期波动急剧放大”,随即优先启用价格短期偏离类配置逻辑,并主动降低长周期平稳类策略权重。模型不仅清晰阐明调整动因——即在方向性冲击与流动性失衡背景下,短期偏离信号对价格发现更具时效性,而长周期逻辑的前提条件已不成立;更对每项操作输出人类专家可追溯、可验证的归因说明,大幅缓解传统金融AI“结论黑箱、逻辑不可溯”的固有缺陷。
为确保结论稳健可靠,研究团队同步实施1万次 block-bootstrap 重采样统计检验,并专门设计 BM25 关键词匹配证伪实验,证实模型判断并非源于关键词机械匹配,而是建立在深层次语义理解基础之上。目前,Alpha-R1 作为前沿学术成果,其论文、代码与模型权重均已全面开源。随着该范式的持续演进与落地,未来有望深度赋能智能投研、动态风控、监管科技等专业场景,为金融行业迈向高质量、可解释、自适应的智能化新阶段提供坚实、开放、可复用的技术基座。


