





近日,腾讯混元团队对外披露了一项重要技术进展:其主推的端侧1.8b翻译模型已成功压缩至数百兆级别,在几乎不牺牲翻译质量的前提下,正式部署于哔哩哔哩(b站)直播弹幕实时翻译系统中,完成了从实验室原型到大规模高并发真实业务场景的关键跃迁。
该模型的基础版本为Hy-MT2-1.8B,隶属于腾讯混元翻译模型系列,原生支持33种语言间的双向互译。在FLORES-200通用翻译基准测试中,其综合表现已在同参数量级模型中超越多个主流商业翻译API。但受限于传统FP16精度下高达3.3GB的内存占用,即便采用4-bit量化仍需超1GB内存,难以适配端侧多任务并行运行的严苛资源约束。为此,腾讯研发了两套超低比特量化方案。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
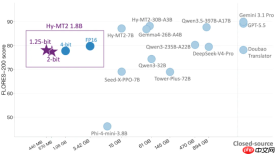
第一档面向中高端设备,采用2-bit量化策略。该方案融合拉伸弹性量化(SEQ)技术,将模型权重映射至特定离散值域,并辅以量化感知蒸馏(QAD),最终将模型体积压缩至574MB,同时保持翻译性能近乎无损。
第二档则面向全平台设备,实现1.25-bit极低比特量化。该方案基于腾讯自研Sherry稀疏高效三值量化技术——该成果此前已被国际顶级自然语言处理会议ACL 2026录用为Oral论文。其核心思想是引入细粒度稀疏机制,每4个参数中仅保留最重要的3个并赋予非零数值,其余置零,从而实现平均单参数仅占1.25-bit的极致压缩效果;再结合专为CPU优化的STQ推理内核,原始3.3GB模型被精简至440MB。
为突破移动端ARM架构依赖,英特尔团队深度参与x86生态适配工作。通过优化量化矩阵运算中的向量化执行、权重重排策略以及VNNI指令融合等关键环节,Hy-MT2低比特模型在英特尔主流平台(涵盖第三代酷睿Ultra及历代酷睿处理器)上的token生成速度显著提升,成功将极低比特能力拓展至PC端与边缘计算设备。
在实际落地层面,哔哩哔哩已完成该极低比特模型在直播弹幕实时翻译场景的全量接入。整套模型资源包下载体积约600MB,运行时内存占用稳定控制在500–700MB区间,单条弹幕平均翻译延迟为500–800毫秒,在常规弹幕密度下可保障流畅、低延迟的实时响应,并能精准理解并翻译各类网络热词与亚文化表达。该本地化部署模式不仅大幅削减云端服务调用成本与网络带宽消耗,更全程避免用户数据上传,从源头筑牢隐私保护防线。


