





骁龙峰会即将拉开帷幕,高通近日在其官方博客中提前透露了新一代旗舰芯片的关键技术细节。结合目前已公开的官方资料,我们能够梳理出哪些确凿无疑的重大升级?首要亮点当属cpu架构——不仅首次实现超5ghz主频,更引入了一套极具颠覆性的缓存管理机制,令人耳目一新。
但在深入解析这些硬核革新之前,有必要先厘清一个关键前提:当前网络上关于这款新旗舰芯片命名的各种猜测,均属未经高通官方认证的民间推测,可信度有限。最终定名仍需等待骁龙峰会现场揭晓。不过,无论最终冠以何名,其CPU部分所实现的底层架构跃迁,才是真正值得聚焦的核心所在。
主频突破5GHz:移动终端架构演进的重要里程碑
高通已正式确认,新一代骁龙旗舰移动平台将搭载全新自研的Qualcomm Oryon CPU,其最高运行频率将首次跨越5GHz大关。这标志着移动SoC领域在量产芯片中首次达成这一历史性频率高度。
5GHz在PC级处理器中早已司空见惯,但要在手机这类散热空间极度压缩、供电能力严格受限的设备中稳定实现,技术挑战呈几何级增长。随着先进制程红利逐步收窄,每提升0.1GHz主频,往往意味着功耗预算需大幅加码。高通之所以能成功突破这一瓶颈,并非单纯依赖制程工艺的迭代,而是源于Oryon作为全栈自研CPU架构所具备的底层可塑性与优化自由度。
当然,高频本身并不等同于高性能,唯有主频与IPC(每周期指令数)协同提升,才能真正转化为用户可感知的流畅体验。Oryon架构自设计之初便将IPC优化置于核心位置——超大容量L1指令缓存显著降低核心“待命空转”概率;精准高效的分支预测单元大幅减少流水线误判导致的冲刷损耗;低延迟执行单元则保障每条指令都能被快速调度与完成。这些微架构层面的深度打磨,叠加5GHz主频优势后,最终呈现出的效果是:应用点击即启、信息流滑动丝滑无卡顿、高负载游戏在团战等复杂场景下帧率依旧稳如磐石。
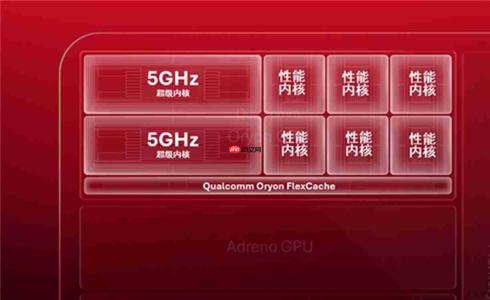
FlexCache:重构缓存逻辑,从“各自为政”迈向“全局共用”
除主频跃升外,高通还在Oryon CPU中部署了另一项影响深远的底层革新——FlexCache智能缓存架构。缓存作为决定IPC实际发挥效率的关键基础设施,在传统多核CPU设计中,各核心通常配备独立私有缓存段。一旦某核心所需数据未命中本地缓存,就必须跨层级访问系统内存,而这段物理路径带来的延迟正是性能瓶颈的主要来源之一。

FlexCache的核心突破在于,将原本分片归属的L2缓存升级为统一全局共享池,所有CPU核心均可直接访问该缓存资源,并由系统依据实时负载动态调配分配比例。由此带来的直接收益是:当超大核正在处理海量数据任务时,不再受制于自身固定容量的缓存限制,而是可按需调用整个共享缓存池,有效规避因缓存溢出引发的性能骤降。换言之,这颗CPU所展现的峰值性能,不再是短暂爆发式的“百米冲刺”,而是可持续输出的“长距离巡航”。
在当下整个行业普遍面临内存带宽吃紧、容量捉襟见肘的大背景下,FlexCache通过显著削减核心对系统内存的访问次数,使CPU即便在内存资源相对紧张的移动端环境中,依然能维持高效运转。对于智能手机这类既追求极致性能、又对功耗与内存带宽极度敏感的设备而言,这项改进意义尤为重大。
5GHz + FlexCache:面向智能体AI时代的双引擎驱动
若将5GHz主频突破与FlexCache共享缓存架构并置审视,便会发现二者并非孤立演进,而是高通为迎接智能体(Agentic AI)时代所精心布局的一组协同技术组合。
智能体AI与传统对话式AI的本质差异在于:它不止于单次问答响应,而是需深度理解用户意图,将其拆解为若干子任务,继而自主调用各类工具、跨应用执行操作、并在多个CPU核心间灵活调度资源,最终闭环完成一个完整目标。这一整套行为链对CPU提出了双重严苛要求:一方面,每个子任务都必须以极低延迟完成,否则整体流程将显得迟滞拖沓——这正依赖5GHz高频所提供的强大单线程瞬时响应能力;另一方面,任务在执行过程中需频繁在不同核心之间切换与接力,其所依赖的数据集也需随之迁移。倘若每次切换都需重新从内存加载数据,累积延迟将不可忽视。而FlexCache所构建的共享缓存池,恰好确保了数据在核心交接过程中零丢失、零重载。
高频保障即时响应,共享缓存支撑无缝流转——两者深度融合,共同构筑起下一代旗舰终端应对智能体AI工作负载的坚实CPU基座。
后续,高通预计还将陆续公布GPU、NPU等关键模块的技术细节。但更全面、更权威的完整图景,仍有待北京时间9月23日至25日(夏威夷当地时间9月22日至24日)举行的骁龙峰会正式揭晓。届时,所有关于芯片命名的纷繁猜测终将尘埃落定,其在图形渲染、人工智能等维度的真实实力也将全面展现在全球开发者与消费者面前。



