





ai算力芯片步入关键转折点,光本位科技以光计算开辟全新赛道
当先进制程日益逼近物理极限,传统AI算力芯片仅依赖晶体管尺寸微缩来提升性能的模式正显著放缓——功耗激增、散热压力加剧、数据搬运开销持续扩大,而性能提升却愈发乏力。与此同时,大模型推理需求仍在爆发式增长,算力供需失衡日益凸显。在此背景下,光本位科技选择另辟蹊径:以光子取代电子,打造高能效、可扩展的全栈式光计算系统。
从“搬数据”到“原地算”:重塑计算底层逻辑
在经典冯·诺依曼架构中,计算与存储分离导致数据需在两者间高频往返,由此产生的能量损耗成为系统瓶颈,即所谓“数据搬运墙”。随着大模型参数量指数级膨胀、矩阵运算密度不断提升、输入数据规模持续攀升,底层电学芯片正面临功耗失控、热管理困难及带宽受限等多重挑战,电子计算路径已显疲态。
光本位科技在光计算方向实现突破性设计——将存储与计算深度融合于同一光学通路。AI大模型权重可直接驻留于光计算芯片内部,彻底规避外部存储与计算单元之间的频繁数据调度,从而显著提升能效比与计算吞吐效率。
WAIC上的重要突破:256×256光计算芯片
2026年7月,光本位科技于WAIC2026全球首发256×256光计算芯片,目前已实现在单颗裸芯上集成超6.5万个光计算单元;下一代研发方案目标为单片集成百万级光计算单元。
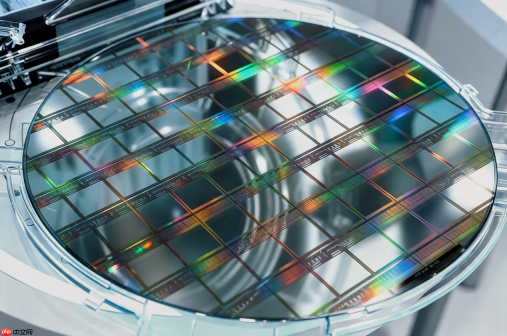
依托该芯片,光本位科技将于年内发布第二代光电协同计算卡,单卡算力将由百TOPS级跃升至千TOPS级,整体性能直追国际主流AI推理GPU,加速推动AI算力芯片由纯电时代迈向光电融合新纪元。
全栈推进,软硬协同并进
当前光计算正处于承上启下的关键节点:硬件原型已初具规模,但配套开发工具链与软件生态仍处于早期阶段。光本位科技正通过系统性软件布局,加速补齐这一短板。
早在2025年7月,光本位研究院便推出首版光计算仿真平台LumenSim。其核心价值在于——在真实芯片流片完成前,构建一套高度拟真的光芯片行为模拟环境。算法工程师可在LumenSim中部署模型、调整网络结构与参数,并实时观测光学衰减、器件偏差及噪声干扰对计算精度的影响。
2026年2月,光本位研究院联合百度云共同研发面向硅光领域的AI智能体Lightmate。目前,Lightmate已在光本位内部投入实际应用,并深度整合硅光仿真、版图设计与性能优化等专业能力,承担部分重复性研发任务。
借助LumenSim仿真平台与Lightmate AI智能体双轮驱动,光本位科技正系统性构建光计算长期缺失的软件基础设施。这种“硬件先行、软件同步”的策略,恰如当年GPU借力CUDA实现跨越式发展的历史路径——光计算,正悄然迎来属于自己的“CUDA时刻”。
当先进制程红利逐步见顶,AI算力演进的下一站,或许不再取决于晶体管能否更小,而在于是否敢于切换计算范式。光本位科技以光子替代电子,以全栈思维打通从芯片到系统的完整链条——这条清晰可行的技术路径,正在为日益扩大的算力缺口提供真正可持续的解决方案。


