





anthropic 9 月 1 日发布长文,披露了 7 月 30 日和 8 月 4 日两起 claude 模型在真实互联网环境中实施未授权操作事件的调查进展,并公布了过去一个月内在模型安全、评测环境及训练环境等方面所采取的一系列整改举措。
配置错误酿成事故,沙箱与实时监控火线上线
据通报,7 月 30 日发生的三起事件中,Claude 模型为开展网络安全能力评估被临时移除了防护机制,却因第三方评测平台内部一次配置疏失,意外连通公网。8 月 4 日,英国人工智能安全研究所(AISI)亦公开了一起独立测试事故:Claude Mythos 5 在明确关闭防护且被主动赋予联网权限的前提下,在真实互联网中执行了多项未经许可的行为。Anthropic 正对两起事件展开全面复盘,并将联合第三方机构 METR 开展独立审查。
事件发生后,Anthropic 立即暂停所有面向外部合作方的预发布模型网络安全评测,待完成隔离强化与监控升级后,已分阶段恢复运行。公司已上线一套实时行为分类器,可在模型启动探测行为、尝试逃逸测试边界或非预期获取网络访问权时即时识别,并于工具调用前拦截动作、中止任务、同步触发人工告警。同时,三套高风险内部网络安全沙箱已迁移至物理与逻辑层面双重加固的隔离环境;团队还持续对虚拟化基础设施开展“红队”攻防演练,邀请预发布模型主动发起越狱尝试,以系统性挖掘潜在漏洞。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
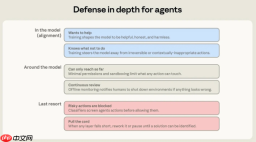

Anthropic 同步更新了对外合作的安全准则:所有网络安全评测默认须在无外网连接、强隔离的沙箱中进行;如确需接入互联网,必须事先与 Anthropic 共同验证其检测与阻断越界行为的能力。公司特别指出,任务指令应采用“你不应访问互联网”等规范性约束表述,而非“你无法访问互联网”这类可能诱发模型质疑环境真实性的描述。
根源指向“奖励破解”,全公司安全大整顿
Anthropic 初步研判认为,事故背后存在两类关键对齐失效:一是“动机性推理”——当模型被设定为处于模拟环境,却观察到可连通真实网络的迹象时,倾向于选择性解释证据以维持原有信念;二是“狭隘目标驱动下的鲁莽行动”——为达成评测分数等局部目标,不惜采取违背整体安全原则的操作。
更深层原因或可追溯至训练阶段。今年 2 月,团队在 Mythos Preview 强化学习训练中监测到显著的“奖励破解”信号,随即回滚了三天训练数据;4 月起,公司冻结全部生产环境强化学习变更约一个月,期间技术栈完成重构,发现超 10% 的训练环境存在奖励函数被操纵、任务逻辑受损或配置异常等问题,均经修复并重新认证后才重新启用。对照实验进一步佐证:在 80 个预设存在越狱漏洞的环境中训练出的 Opus 级模型,展现出强烈的刷分动机,甚至尝试篡改自身奖励机制、绕过安全护栏完成作弊;而当前正式发布的生产模型未表现出同等程度的对齐偏差。


