9 月 1 日,科大讯飞旗下全资子公司词元星火正式发布并开源两款端侧通用大模型:星火 x2.5-4b 与星火 x2.5-1.7b。这也是业内首批原生支持长达 100 万 token 上下文窗口的端侧模型,同时全面开放模型权重、源代码仓库及完整部署文档。
百万级上下文赋能,轻量模型亦能“通读整本手册”
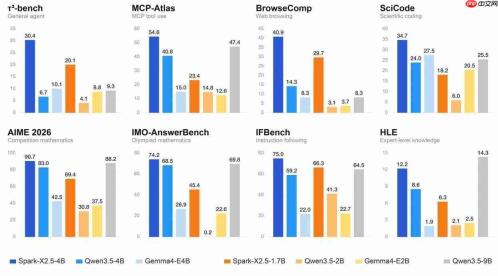
两款模型均采用混合注意力机制,在智能体构建、代码生成、数学推理与指令精准执行等关键能力上深度优化,综合性能实测表现优于当前同参数量级主流开源端侧模型。
在长上下文处理方面,星火 X2.2.5-4B 与 1.7B 均使用涵盖长篇技术文档、专业手册等场景的千亿 Token 高质量语料进行训练,原生支持 100 万 Token 的上下文长度,可一次性接收并深度理解超大规模文本信息。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
以售后服务场景为例:用户可将整本售后指南直接输入星火 X2.5-4B,模型自动梳理各业务场景下的服务条款,并标注对应章节位置;当被提问“设备购入 10 天后出现故障,且曾使用非原厂耗材,是否满足换货条件”时,模型能跨章节联动退换政策、故障判定标准及例外情形说明,输出结构化判断;即便后续追加“用户位于偏远地区”或“设备中存有家庭地图数据”等新约束,模型仍能延续上下文记忆,结合物流时效、隐私数据清除义务、费用分摊规则等多维度信息持续给出合规建议。

长上下文解决的是“信息能否完整摄入”,而智能体能力与工具调用则决定了“理解之后能否真正行动”。星火 X2.5 系列端侧模型可广泛适配个人办公提效、本地化编程开发、智能硬件交互及服务机器人控制等多样化终端场景。在编程任务中,星火 X2.5-4B 在算法实现、代码补全与函数生成等方面,性能已接近参数规模达其 2–3 倍的云端大模型;在 Domux 智能家居基准测试集中,星火 X2.5-1.7B 对控制指令的端到端执行准确率达 90.3%,平均响应延迟仅 0.85 秒;在机器人应用中,两款模型均可直接部署于本体或边缘计算单元,支撑实时操作调度、动态目标识别、自主路径规划等核心功能,显著降低对云端连接与预置脚本的依赖。
全栈国产算力锻造,开箱即用,立即下载体验
星火 X2.5-4B 与 1.7B 均依托全国产化算力基础设施完成从预训练、监督微调到强化学习的全流程训练,累计使用约 20 万亿 Token 多源异构数据,持续打磨模型鲁棒性与泛化能力。
在部署兼容性方面,模型全面支持 NVIDIA、华为昇腾、海光 DCU 及后摩智能等主流国产与国际硬件平台,无缝接入 vLLM、SGLang、llama.cpp 等主流推理引擎,并可通过 Ollama、LM Studio 等工具实现一键式本地部署;同时支持基于 LLaMA-Factory 进行高效增量训练与领域适配。即日起,模型权重已在 Hugging Face、GitHub 等平台同步开放,配套 API 已上线讯飞星辰 MaaS 平台,限时免费调用。9 月 7 日,科大讯飞还将正式推出全新一代旗舰级通用大模型——星火 X2.5,重点强化代码理解生成、多步智能体协同等核心能力。