





字节跳动旗下 seed 团队在其最新发表的研究论文中,深入剖析了大语言模型在处理超长文本时性能不稳定的根本技术成因。研究指出,该问题的核心在于分块 kv 缓存压缩策略所引发的“相位敏感性”。
核心机制导致检索失衡
为缓解长上下文推理过程中的显存压力,该压缩方法采用固定步长对连续 token 窗口进行降维聚合,生成更紧凑的缓存条目。但此举意外引入了一个新的位置维度——即每个 token 相对于压缩窗口起始边界的“相位”偏移量。
实证结果显示,即便输入内容完全一致,仅因 token 所处相位不同,模型的检索表现即可能出现显著波动。在若干主流开源大模型中,由相位差异引发的长文本检索准确率最大落差高达 40%。

One API key for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more
下载
统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
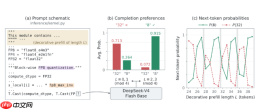
周期性缺陷呼唤架构革新
该成果暴露出常规平均型基准测试的固有盲区:某些模型虽在整体指标上表现优异,却可能在特定相位区间内存在系统性失效。随着长文本应用场景持续拓展,此项研究为下一代模型结构设计及长上下文推理鲁棒性增强提供了关键理论支撑。






