





碰到图里的文字无法直接复制,再也不用逐字手动敲了。以下汇总了3种高效、完整的图片文字识别方案:第一种借助极轻pdf,先将图片批量转为pdf,再通过ocr功能提取文字;另两种工具(ilovepdf、pdf24)则可直接对已有的pdf扫描件执行ocr或文本提取,全程覆盖入口定位、文件上传、参数确认、识别执行、结果下载及质量核验等全流程。
方法一:用极轻PDF先转PDF再做OCR
极轻PDF(pdf.cn)的「OCR PDF」功能仅支持PDF格式输入。若原始资料为JPG、PNG等图像文件,需先通过「图片转PDF」生成标准PDF文档,再将其导入OCR工具完成文字识别——两步协同,确保图像内容完整、结构清晰、文字可编辑。
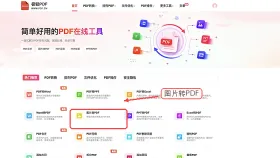
步骤一:进入图片转PDF工具
访问极轻PDF官网首页,在“转为PDF”功能区精准找到并点击「图片转PDF」入口。务必注意名称区分,避免误入「PDF转图片」等反向功能,防止操作返工。
步骤二:上传需要识别的图片
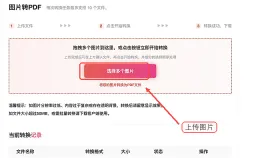
进入工具页面后,点击「选择多个图片」按钮,一次性上传所有待识别的JPG/PNG文件。建议上传前统一校正图片方向(如旋转倒置、横屏),并剔除模糊、过曝或严重反光的低质图像,提升后续OCR准确率。
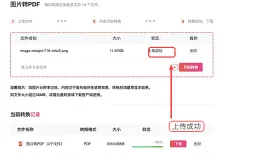
步骤三:确认图片上传成功
等待文件列表中完整显示各图片名称、尺寸,并明确标注“上传成功”状态后再继续。若状态栏长时间未更新,建议暂停操作、刷新页面后重新上传,避免因缓存或网络异常导致任务失败。
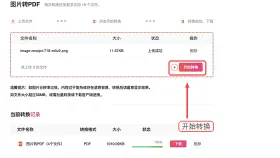
步骤四:开始转换为PDF
确认全部图片已正确加载且顺序无误(系统严格按上传顺序排版),点击「开始转换」启动合成流程。转换过程中请勿关闭页面或重复点击,静待进度条完成即可。
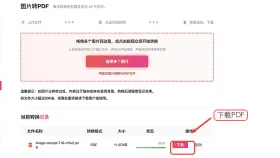
步骤五:下载转换后的PDF
转换完成后点击「下载」获取生成的PDF文件,并保存至本地设备。该文件将作为下一步OCR识别的唯一输入源,请勿跳过此环节直接尝试上传原图。
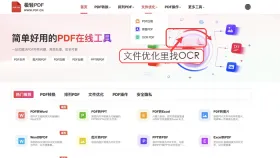
步骤六:进入OCR PDF工具
返回极轻PDF首页,在「文件优化」分类下定位并点击「OCR PDF」功能。进入前请再次核对页面标题是否为“OCR PDF”,防止误入“PDF压缩”“PDF加密”等相近模块。
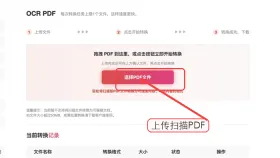
步骤七:上传刚生成的PDF
点击「选择PDF文件」,从本地选取上一步下载的PDF文档上传。注意:此步骤不支持JPG/PNG直传,若提示格式错误,请返回前序流程检查PDF生成是否完整、有无损坏。
步骤八:核对上传状态
上传完毕后,页面应同步显示文件名、大小及“上传成功”标识。三项信息均匹配原始PDF属性后,方可进行下一步操作,切忌在状态未就绪时强行启动识别。
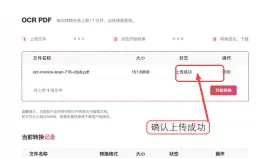
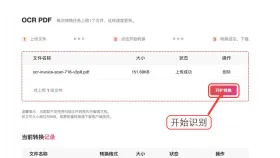
步骤九:开始OCR识别
点击「开始转换」触发OCR引擎。系统将自动检测语言(默认中文简体)、启用高精度识别模型。原始图像越清晰、角度越正、背景越干净,识别准确率越高,后期校对工作量越小。
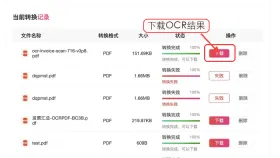
步骤十:下载OCR结果
识别完成后点击「下载」获取含可编辑文字层的PDF或纯文本文件(依设置而定)。打开结果后重点核查:数字与单位是否一致、标点符号是否缺失或错位、表格边框是否断裂、生僻字及专业术语是否识别正确。
方法二:使用iLovePDF处理PDF扫描件
若原始资料已是扫描型PDF(如合同、票据、试卷照片导出的PDF),可跳过图片转PDF环节,直接使用iLovePDF的「OCR PDF」功能进行端到端识别,节省中间步骤,同时支持多语言识别与输出格式选择。
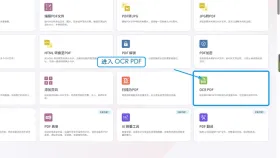
步骤一:找到OCR PDF入口
在iLovePDF官网工具导航栏中,准确识别并点击「OCR PDF」功能入口。注意避开名称相似的「扫描为PDF」或「PDF转图片」,二者逻辑不同,误选将无法启动OCR识别。
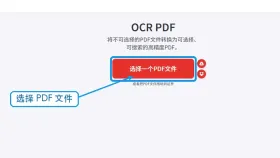
步骤二:上传PDF并识别
点击「选择一个PDF文件」上传扫描件,系统自动加载并提示OCR选项(如语言、输出格式)。确认设置后点击「识别文字」启动处理。完成后下载结果,建议抽查首页标题、页码编号、金额字段及关键段落,验证语义连贯性与格式完整性。
方法三:使用PDF24提取PDF文字
PDF24提供轻量级「PDF转换为文本」工具,适用于对排版还原要求不高、仅需提取纯文本内容的场景。其界面简洁、响应迅速,适合快速获取基础文字内容,尤其适合处理结构清晰、无复杂图表的扫描PDF。
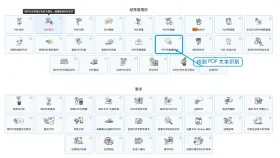
步骤一:进入PDF文本识别工具
在PDF24官网工具集合中,查找并点击「PDF文本识别」(部分版本显示为“PDF to Text”)。注意与其他功能如“PDF转Word”“PDF转JPG”区分,确保进入的是纯文本提取路径。
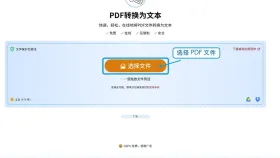
步骤二:选择PDF并下载文本
点击「选择文件」上传目标PDF,系统自动解析并生成TXT文本。处理完毕后点击「下载」获取结果。建议将文本与原始PDF逐段比对,重点关注表格数据、编号序列、金额数字及特殊符号(如¥、®、℃)是否准确保留。
识别结果怎么检查
建议采用“三查一比”法进行质量复核:
✅ 查首尾:快速浏览每页开头与结尾,确认段落起止、标题层级是否合理;
✅ 查密集区:聚焦数字、日期、电话、身份证号、金额等易错字段,验证准确性;
✅ 查易损点:放大查看小字号文字边缘是否锐利、标点是否粘连、换行是否断裂;
✅ 比原文:随机抽取3–5页,将识别结果与原始图片/PDF逐句对照,尤其关注模糊、倾斜、阴影区域的文字还原度。
若发现大面积识别偏差,优先检查原始图像质量——调整亮度对比度、裁剪冗余边框、校正倾斜角度后再重试,而非反复修改识别结果,可显著提升效率与准确率。多页文档还需额外核对页码连续性与整体顺序,避免漏页、跳页或乱序。


