





视频后期,危。
就在刚刚,MiniMax 正式发布了全新一代视频模型—— MiniMax H3。
也是他们的首个开源视频模型。
坦率地讲,这是今年继 Seedance 之后,第二个让我感到「后背发凉」的时刻。
现在,你可以直出这类「手绘」视频特效,宛如魔法一样。
△AI 生成
无论是添加灵动的花体字,还是渲染复杂的字幕动画,它都能直接端到端生成。
并且清晰度默认 2K。
△AI 生成
如果你也是名 AI 视频玩家,应该知道我想说什么。
过去一年,视频模型因 Scaling 红利已获得了突飞猛进,但至今有一项定位未曾变化:它们只负责为你提供 「一段素材」。
素材生成后呢?你还得把它拖进 PR 里,加字幕、调色、做转场、配音乐、套模板……反正后面还有「一万件」事在等着你。
但 H3 彻底打破了这个范式。
它将剪辑逻辑、字体排版、转场设计、节奏把控、背景音乐以及视觉特效,全部「端到端」地集成到了模型之中。
输入一段文本,它直接还你一个可以一键发布的成品。
△AI 生成
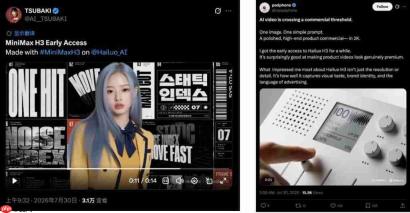
X 上也是玩疯了,海外开发者们已经玩疯了,社区公认其为全新的 SOTA 视频模型。
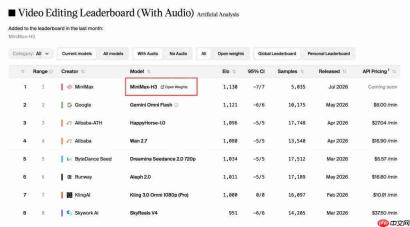
在新鲜出炉的 Artificial Analysis 榜单上,H3 也是毫无疑问地斩获了视频编辑的第一。
也是很神奇,唯一开放权重的竟然也是第一名。
说实话,我曾一直固执地认为,「后期」会是人类创作者最后的护城河。
AI 或许能生成精美的素材,但如何运用剪辑技巧、光影调度与特效来「讲故事」,这些必然需要人类独有的主观审美与情感共鸣。
现在我收回这句话。
MiniMax H3 新鲜出炉
看到消息后,我立马打开官网,开始实测。
正式开始测试,我决定先跑一个简单的男团「出道花絮」热热身,看看这个模型的基础能力怎么样。
我把如今硅谷 AI 圈最嚣张的三个男人放在了一起。Sam Altman、Dario Amodei、马斯克。
我管这个新男团叫「AGI Boys」(doge)。
生成完第一遍我就觉得有点离谱了。
△AI 生成
说实话,之前看到官方 demo 里那些手绘视觉特效、动态片头、混剪预告,说实话心里是有点怀疑的。
抽了几次卡之后,我服了……
这个模型,对用户意图的嗅觉真的异常灵敏,只用给文本,就马上能理解我想要什么视觉和剪辑风格。
就比如下面这个模型宣传片,我就只在 prompt 里加了一个 tag,苹果发布会风格,然后 H3 就直出了一个平行宇宙中的「苹果版 MiniMax」。
说实话,这个玻璃特效、这个渐变,太对味了……
△AI 生成
然后我决定上强度。
这次的年度大戏主题名为「AGI 复仇者联盟」,Dario 和马斯克联手,准备找 Sam Altman 一雪前耻。
我写了一版非常长的 prompt,大概描述了一个六分镜的预告片。每个分镜我都写了不同的情绪方向、表演逻辑,并且节奏相当快。
结果,我给的每个分镜,H3 都完美遵守了。
尤其是后面蒙太奇 Dario 崩溃捶桌子那段,你要知道,我这周刚看完《痴迷》,这视频直接给我干 PTSD 了。。。
△AI 生成
对了,你别说,掉小珍珠的 Dario 竟然也别有一番风味。
好好好,可恶的 Dario,哭,给我哭!!!
(bushi)
最后是一个 Gold Chain 短视频宣传片,各类动效尽显 AGI 黄金时代的奢华,一根项链价值一张 H200(bushi)。
△AI 生成
好了,看完最精彩的原生后期,我们再来看下一项很重要的维度——文字。
AI 在视频里呈现文字,一直以来都是翻车重灾区。
图片生成现在基本已经解决了汉字问题,GPT Image 2、NanoBanana 都能在图片里写对字。
但到了视频,这个难度直接指数级上升。因为文字不能只在一帧里是对的,它要在每一帧都保持同一个形态。只要有一帧崩了,那就是全盘皆输。
H3 在这块的处理,我觉得是到了一个可以商用的水平。不是 100% 完美,但「能用」是没啥问题了。
就比如这个纯歌词 VJ,说实话,其实能满足绝大部分卧室音乐人的需求了。
△AI 生成
而且有一个让我很在意的点,H3 不只是把文字贴上去,它似乎能理解文字和画面之间的关系。
我又做了个超豪华钻石项链 VJ(原谅我真的很爱 gold chain),结果 H3 给文字也镶上钻了,有光影的变化、有景深的过渡,而不只是视频上面叠了一行字。
△AI 生成
我知道聊文字生成听上去不够性感,不如手绘特效那么炸裂。
但仔细想想,这其实才是离商业化最近的能力,文字信息能保证正确,AI 视频就可以去接广告,做品牌物料了。
还有一个我觉得很强但容易被忽略的能力,你可以直接丢一段音频教 H3 读台词,而且不是那种生硬的 TTS 念稿,声音是跟着画面的情绪和节奏一起走的。
△AI 生成
这其实也是 MiniMax 的老本行了,他们很早就在多模态语音模型上有积累,这次相当于是把语音能力和视频能力在同一个模型里打通。
最后,就到了大家最关心的问题——价格如何?
答案是,巨便宜。
具体细节大家可以看 API 定价表,直观理解的话,H3 在 2K 分辨率下每秒价格不到主流模型的 1/3, 768P 分辨率下不到 1/2。
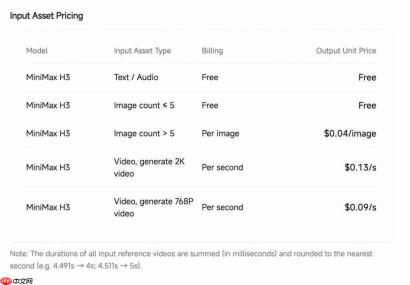
那还说啥了,感动流涕了家人们。
多模态「全家桶」
所以,H3 究竟是怎么做到的?
在讲模型前,先说一个容易被忽略的细节—— H3 是支持全模态输入的。
也就是说,不仅是文字,图片、音频、视频……所有素材都是模型理解上下文的一部分。
而上下文,很大程度上就是决定所有 AI 输出效果的基石。
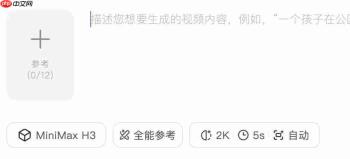
没办法,文字这个东西,作为 prompt 载体,信息密度真的低得令人发指。你要描述一个场景的光影氛围,写三百字可能还不如直接丢一张参考图进去管用。
这也是我自己一直在用的「邪修」。全模态、全参考,能用图就不用字,能用视频就不用图。
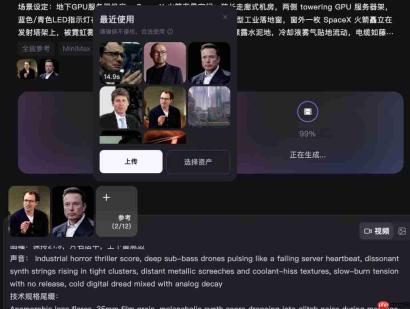
而且 MiniMax 做了一个很小但我非常喜欢的功能,你传过的所有素材都会被缓存到一个「最近使用」里面。不用你自己建文件夹分类管理,P 人的终极福音。
此外,精准编辑能力的提升则在模型层面进一步保证下限。
现在的视频模型有个共同的问题,同一个 prompt、同一张参考图,你生成十次,十次都不一样。
没办法,模型毕竟还是在像素画布上填空,一帧有这么多像素,自然会出现无数排列组合。
创作者把这个叫「抽卡」。
H3 解决这个问题的办法是,它对画面、动作、风格、空间关系这些东西有一层综合理解,从而在语义层面理解了「你想改的是什么」。
结果就是可控性大幅提高。你可以真的实现稳定的言出法随。
除此之外,今天上午 MiniMax 也公布了更多关于底层技术路线的信息。
也比较符合我的预期,为了更好地利用多模态上下文,团队在 Omni 方向上做了大量工作。
首先就是上下文的 Caption。
多模态语境下,H3 中 Caption 的含义被大幅拓宽。不再只是「描述目标视频」,而是要同时刻画上下文与目标视频的关系,甚至理清上下文内部各元素之间的关联。
这本质上是一种上下文 Omni 表征。语言在这里充当了可泛化的「胶水」,这是 H3 指令理解能力的根源。
为了做到这一点,MiniMax 专门定制了 Caption 模型,搭了一整套全模态理解管线。
其次,团队搭建了一套名为 H3-Omni Transformer 的原生 Omni 架构,主打多模态场景下的通用 + 高效。
看到这,我觉得 H3 的一切能力,都可以归因到同一个第一性原理——
多模态 + 语言的涌现。
图像、视频、音频……这些自然模态紧密交织,是人与世界交互的基本媒介,承载了海量信息。
而语言,正是连接这些多模态孤岛,最好的桥梁。
事实上,MiniMax 自创立之初,便坚定布局多模态产品矩阵,这也是这家公司最旗帜鲜明的特点。
如今,一切终于连点成线——
H3 的发布,是此前多模态技术沉淀的集大成,也是团队基因和传统的又一次延续。
敬开源
最后,再说说一件我觉得非常惊喜的事。
H3 这样一款 SOTA 级的视频模型,竟然选择了开源???
这对有内容需求的企业来说,意义自然不言而喻。
如果仅仅依赖云端 API,谁也不敢轻易将资产上传至第三方服务器。
但如果是一个可私有部署的模型,意味着能够毫无顾忌地用自有数据进行微调,围绕核心 IP、品牌画风与专属内容工作流进行深度定制。
至于成本,从 Infra 的演进规律来看,在云厂商、推理平台与开发者社区的共同推动下,推理成本的长期下降是必然趋势。
技术和成本的门槛双双降低,H3 的开源,极有可能带来一场 IP 生命力的全面爆发。
但我始终认为,上述种种,都还不是开源最核心的意义。
开源的真正价值,不在于技术普惠,也不在于成本削减——而是它赋予了所有消费者,一张能与科技巨头坐上谈判桌的筹码。
而 MiniMax,在这条路上已经坚守了很久。
从文本模型 M2 系列开始,他们每一代模型都在拓展开源的边界。如今 H3 的问世,更是将这条开源之路,轰轰烈烈地铺进了视频生成的深水区。
这也是他们一直以来坚持的公司愿景:Intelligence with Everyone(让智能与每个人同在)。
回看魔幻的 7 月,如果说 Kimi K3 冲锋在前,扛起了 Coding 的开源大旗;那么 MiniMax H3,则在视频模型的赛道上,毅然立起了另一面旗帜。
过去大家觉得视频模型就是纯娱乐,如今,H3 已然进化成真正可商用的生产工具,视频生成,正式进入「Coding 时刻」,面向真实场景交付。
而这个 SOTA 视频生产模型,是开源的,它来自 MiniMax。
中国开源的声音,这不是第一次响起。
也绝不会是最后一次。
MiniMax H3 体验地址:https://hailuoai.com/
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
点亮星标
科技前沿进展每日见


