





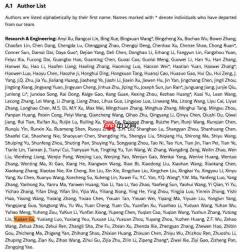
近期,deepseek 进一步加快人才引进步伐,招聘范围涵盖算法、研发、产品、运维、数据工程及职能类等多元岗位。与此同时,deepseek v4 正式版本计划于本月内正式发布。据公开信息显示,清华大学计算机系2021级博士研究生、2025年研究生特等奖学金得主顾煜贤已正式加盟 deepseek,其姓名亦出现在 deepseek v4 相关论文的作者署名中。
DeepSeek
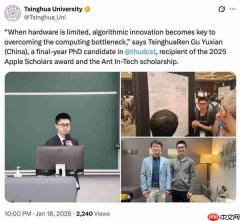
公开资料显示,顾煜贤本科与博士均就读于清华大学计算机科学与技术系,当前研究聚焦于大语言模型全周期效率优化,覆盖预训练、下游任务适配及推理部署等核心环节。他在个人主页中指出,主要研究方向包括高质量预训练语料筛选、面向轻量化部署的知识蒸馏策略,以及兼顾性能与效率的新型模型结构设计。他强调,在算力资源受限背景下,算法层面的创新是突破计算瓶颈的关键路径。
学术成果方面,顾煜贤曾荣获2025年度苹果博士奖学金及蚂蚁集团“In-Tech”奖学金。其 Google Scholar 页面显示,相关研究成果总引用量已达约5000次,其中《预训练模型:过去、现在与未来》与《MiniLLM:大语言模型的知识蒸馏》两篇论文单篇引用均超千次。作为第一作者,他多次在 NeurIPS、ICLR、ACL 等国际顶级人工智能会议发表原创性工作。
其代表性成果之一为 Jet-Nemotron 系列模型。该系列采用混合式架构设计,核心技术包含后神经架构搜索(Post-Neural Architecture Search)机制与 JetBlock 线性注意力模块。根据公开论文披露的数据,2B 参数规模版本在多项基准测试中表现优于 Qwen3、Qwen2.5、Gemma3 和 Llama3.2 等主流开源全注意力模型,并在 H100 GPU 平台上实现最高达 53.6 倍的生成吞吐量提升(测试条件:上下文长度 256K,最大批处理规模)。
此外,顾煜贤与其合作者于2024年提出的 MiniLLM 方法,通过重构知识蒸馏目标函数,显著提升了大模型能力向小模型迁移的保真度与泛化性。实验表明,该方法在指令遵循任务中可有效提升响应准确率、缓解曝光偏差问题,并增强长文本生成稳定性。目前,该技术已被谷歌、阿里巴巴、英伟达等多家头部科技企业及开源社区集成应用。随着 DeepSeek V4 即将面世,顾煜贤的加入无疑将进一步强化其在大模型前沿技术研发方面的实力与影响力。


