





近日,据海外媒体报道,上海交通大学联合苏黎世联邦理工学院等多家科研单位,共同研发出一种名为cosm的创新性协同调度架构,旨在应对智能手机在部署端侧大语言模型过程中面临的高能耗挑战。研究表明,在当前主流移动设备上执行ai推理任务时,高达60%以上的电能并未被用于核心计算环节,而是耗费在处理器与内存之间的海量数据搬运过程之中。
AI
随着大模型加速向终端设备下沉,本地化AI推理不仅需满足低延迟响应需求,还必须兼顾功耗约束、热管理能力以及内存带宽瓶颈。研究指出,当运行参数量约为70亿的模型时,系统需频繁将存储于主存中的海量权重与激活值调入计算单元,这一过程不仅显著推高功耗,还易引发机身发热及输出速度不稳定等问题。
COSM采用的核心技术路径是PIM(Processing-in-Memory,存内计算),即把部分算力模块嵌入或紧邻内存单元部署,使数据尽可能“就地处理”,大幅削减往返CPU/NPU的数据传输频次。然而受限于智能手机内部空间与成本压力,CPU与PIM通常共用同一套内存资源,二者并发访问时极易发生资源争抢与性能干扰。

据CNMO科技获悉,为缓解上述冲突,COSM引入了具备中断能力的PIM指令集,并构建了一套基于CPU内存访问空闲周期的智能调度机制。该机制可在CPU发起内存请求时,令PIM主动暂停执行;同时精准识别CPU访问间隙,将PIM计算任务动态插入这些“时间缝隙”中,从而实现CPU与PIM对共享内存资源的高效错峰利用。
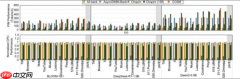
实验数据显示,在对比传统调度策略的基础上,COSM方案最高可实现PIM吞吐量提升达2.8倍,且CPU整体性能损耗被严格控制在2%以内;在大模型推理与常规手机应用并行负载场景下,AI推理吞吐量提升幅度最高达2.6倍,其他前台任务性能下降幅度不超过2.2%,单个Token生成所消耗的能量亦显著减少。


