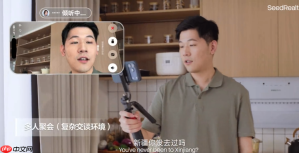
8月5日,字节跳动seed团队正式发布原生音视频全双工大模型——seedrealtime。该模型基于统一架构设计,原生集成音频、视频与文本模态,支持在持续流动的多模态信息中实现低延迟、高响应的实时交互,真正达成“边看、边听、边说”的自然交互新范式。
SeedRealtime在三项关键能力上取得重要进展:一是音视频协同理解能力,可深度耦合声学信号、视觉画面及时间序列特征,并依托上下文场景精准消除语义歧义;二是主动式交互能力,模型具备持续环境感知能力,能在目标对象出现或关键事件发生时自主发起提示或干预;三是节奏自适应对话能力,可动态识别最佳应答时机,智能过滤无关背景对话与环境噪声,大幅降低误唤醒率。
端到端人工评估结果表明,相较于传统分阶段级联方案,SeedRealtime将对话节奏异常问题降低50%,单轮交互的连贯性与语义完整性显著增强。目前,该模型已全面接入豆包App,成为业内首个实现音视频全双工技术大规模商用落地的大模型产品。
豆包Seedream模型
下载
Doubao-Seedream-5.0-lite是字节跳动发布的最新图像创作模型。该模型首次搭载联网检索功能,能融合实时网络信息,提升生图时效性。同时,模型的聪明度进一步升级,能够精准解析复杂指令和视觉内容。此外,模型在世界知识广度、参考一致性及专业场景生成质量上均有增强,可更好地满足企业级视觉创作需求。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜