





近年来,围绕视频生成模型构建的世界模型(world models)正成为人工智能研究的重要前沿方向。sora、genie、cosmos、v-jepa 等代表性视频生成模型,均隐含着一个关键假设:当模型接触海量真实世界视频后,可能逐步发展出“物理直觉”,从而真正理解现实世界的运行机制。
但一个根本性难题始终存在:我们缺乏可靠的工具来检验这一假设是否成立。
这些模型所生成的视频,到底是严格遵循物理规律,还是仅靠统计模式拟合出“看起来合理”的表象?它能否像牛顿那样,基于定律进行因果推理,而非如亚里士多德般依赖经验性类比与模糊直觉?
为回应上述挑战,南洋理工大学 S-Lab 团队联合多方研究者,正式推出首个以物理定律为锚点的视频模型评估基准——Apple-π。实验结果揭示,当前主流视频生成模型距离具备可信物理一致性与泛化能力的世界模拟器仍有显著鸿沟,即便是最先进的模型,其综合得分也仅为 0.473。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/772bb9fbaccf2ee52cd8e7073b88332f
研究团队强调,即便某些模型能依据标注清晰的第一帧生成视觉上连贯的运动序列,这也不意味着它们真正掌握了物体间的空间关系、内化了基本物理法则,或能在不同初始条件下稳定复现一致的动力学行为。
该工作意在推动视频生成模型从“像素拟合”迈向“物理建模”,但必须指出:属于世界模型的“ChatGPT时刻”尚未到来。要实现这一跃迁,还需在场景深层理解、物理推理数据规模、以及面向因果推理的专用后训练范式等方面取得突破。
Apple-π:扎根物理定律的评估新范式
Apple-π 是首个将物理定律作为核心评估维度的视频模型评测基准。它不仅要求模型识别关键物理量,还需准确表述支配性原理、推演符合定律的后续演化,并精准定位推理链中失效的具体环节。
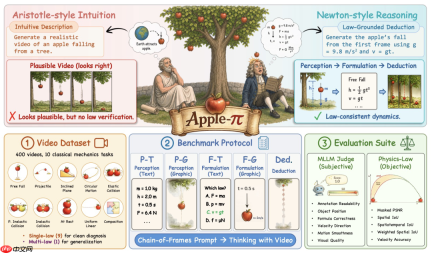
图|Apple-π 概览。
其整体架构包含三大部分:
1. 视频数据集:Orchard
涵盖 400 个精心构造的经典力学视频样本。所有视频均基于明确设定的物理定律与初始条件生成或筛选,任务类型分为单一物理规律与多规律耦合两类,覆盖重力作用、弹性/非弹性碰撞、惯性运动及多阶段动力学衔接等典型场景,重点考察模型对位置与速度状态的持续更新能力。
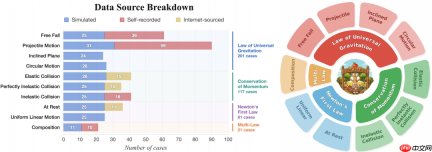
图|Orchard 概览。
2. 基准协议:三阶分层评测框架
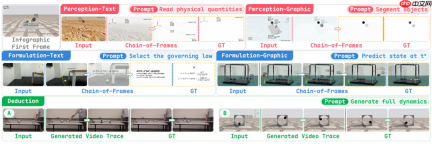
Apple-π 将每个 Orchard 案例解构为感知、表述、推导三大能力模块,并进一步细分为五个子轨道,实现对物理推理能力的精细化拆解与独立评估:
- 感知-文本:复现画面中的数值信息与结构化标注;
- 感知-图形:准确定位实验对象并保持其几何语义完整性;
- 表述-文本:从候选公式集中识别支配性方程,并完成变量代入;
- 表述-图形:预测目标时刻物体的空间位置与瞬时速度矢量,并可视化标注;
- 推导:仅凭首帧初始条件,端到端生成完整物理演化视频。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
图|Apple-π 基准协议。
3. 评估套件:多维融合评分体系
Apple-π 采用混合评估机制:一方面引入多模态大语言模型(MLLM)裁判,对回答逻辑性、格式规范性及生成画面质量进行主观判分;另一方面,在具备物体掩码与真值轨迹的赛道中,引入物理真值指标(Physics-grounded Metrics),量化物体定位偏差、轨迹拟合误差与速度一致性,严格检验运动过程是否满足守恒律与微分方程约束。所有子项得分统一归一化至 [0,1] 区间。
各类模型在物理推导环节普遍表现薄弱
研究团队在 Apple-π 全量基准上系统评测了 11 个具有代表性的视频生成模型。总体趋势显示:视频预训练、推理导向微调及统一多任务建模,均有助于提升模型在感知与表述层面的表现;然而,所有模型在物理推导任务上的性能均显著受限。
细分来看:专有闭源模型整体优于基础开源视频模型,表明大规模高质量视频训练确可隐式蒸馏出部分物理先验;经视频推理任务微调的 VBVR-Wan2.2 在同类模型中展现出更强竞争力;而 GPT Image 2 与 Nano Banana 2 的领先表现,则印证了显式物理理解能力与可控视觉生成机制,对标注解析、物体 grounding 及终帧生成具有实质性增益。
即便如此,当前最优模型的综合得分仍止步于 0.473,凸显物理运动推理仍是制约世界模型发展的核心瓶颈。
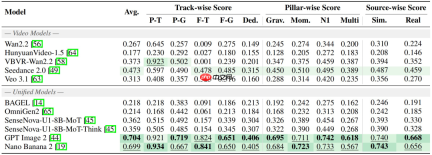
图|主要结果。
为进一步定位模型失败根源,Apple-π 将整个推理流程划分为感知 → 定律建模 → 动态推演三个阶段,分别评估其在观测提取、物理对齐、因果推理与视频生成各环节的能力边界。
分析发现,模型错误并非仅集中于最终输出阶段,更频繁出现在中间推理环节:部分模型虽能完成标注识别与物体定位,但在物理规律选择、状态变量迭代更新、以及后续运动轨迹预测等关键步骤上仍严重不足。其行为本质仍是依赖浅层视觉模式匹配,尚未建立鲁棒、可泛化的物理状态表征与演化机制。
当前局限
尽管 Apple-π 显著提升了视频模型物理能力评估的深度与严谨性,但仍存在若干待拓展方向。
首先,物理覆盖范围有限。当前基准聚焦于经典刚体力学范畴,涵盖重力场运动、动量/能量守恒型碰撞、惯性定律及其简单组合,尚未涉及流体动力学、热传导、电磁相互作用、材料断裂、颗粒物质行为、生物力学乃至量子尺度现象。
其次,物体与场景多样性不足。Orchard 数据集中动态实体仅限球体、立方体、圆柱体与圆锥体四类理想几何体;且全部视频采用固定视角拍摄,未直接测试模型对多视角一致性、新视角合成或三维空间关系建模的能力。
第三,输入依赖性强。Apple-π 当前设定需依赖人工标注的第一帧来锚定场景结构与物理参数映射关系,因此主要衡量模型在已知视觉上下文下的物理推理能力,尚未检验其能否仅通过自然语言描述自主构建完整可计算物理场景。
此外,评估方法本身亦存挑战。MLLM 裁判难以完全判定物理过程的内在正确性,故 Apple-π 需辅以掩码精度、像素级轨迹误差、速度矢量偏差等客观指标;而这些指标又易受分割算法鲁棒性、图像渲染差异及标注噪声干扰。
最后,时间维度建模尚不完善。当前评估默认将模型输出视频的帧数长度等价于提示中指定的物理时间跨度,但实际视频生成服务常返回固定时长容器,导致时间归一化失准,进而影响动力学一致性判断。





