7月25日傍晚,openai旗下api、chatgpt与codex三大服务同步出现异常,共计31个服务组件性能下滑,历时1小时51分钟方才全面恢复。
单次故障本身尚可理解,真正引发关注的是——OpenAI已连续17天未实现全天候稳定运行。
惊险一断
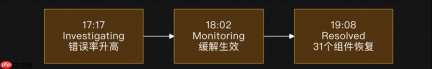
北京时间7月25日17时17分,OpenAI官方状态页面首次标出“Investigating”:多项核心服务错误率显著上升。18时02分状态更新为“Monitoring”,表明缓解措施已启动并初见成效;至19时08分,平台正式宣告全部服务恢复正常。
本次影响横跨三大业务线:API涉及12个组件、ChatGPT波及15个组件、Codex牵连4个组件,总计31个服务单元响应延迟或失败。 第三方监控平台Bifrost记录的故障起始时间为UTC时间09:17,与官方通报时间严丝合缝。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
终端用户的实际体验极为明显:请求频繁超时、返回内容错乱、任务中途终止。尤其值得注意的是Codex的异常表现——作为面向开发者的编程Agent底层服务,其卡顿常达数十分钟,若正执行复杂工程任务,极易导致整条流水线中断甚至项目失败。
连续17天“带病上岗”
将时间轴拉宽至近一个月,此次事件便不再是孤立插曲。
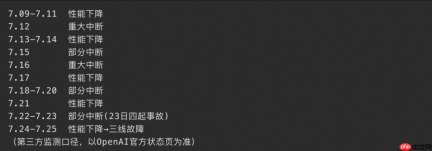
据第三方状态追踪平台Bifrost统计,自7月9日起,OpenAI再无任何一天达到“Fully Operational”标准:7月12日与16日发生两次Major Outage(重大中断),其余日期则持续在Degraded Performance(性能下降)与Partial Outage(局部中断)之间反复震荡。
另一监测平台incidenthub的数据同样密集:仅7月23日单日,OpenAI即触发四起独立告警,涵盖ChatGPT错误率飙升与响应延迟;24日Codex Review模块报错;25日则演变为三线全线告急。

通过本地 Codex 或 OpenClaw OAuth 凭证直接调用 ChatGPT/Codex Responses 的 image_generation 工具来生成或编辑光栅图像,然后保存
关于故障成因,官方至今未作说明。业内普遍推测存在两大可能:一是夏季全球推理请求量持续攀升,基础设施长期处于高负载临界状态;二是伴随新模型迭代与功能快速上线,系统稳定性承压加剧。以上均为合理推断,最终结论仍待官方事后复盘报告。
Agent时代,宕机的代价升级了
两年前ChatGPT短暂中断,用户损失的仅是对话体验;而2026年的这次故障,已悄然切换赛道。
如今API背后支撑的是真实生产环境:智能客服系统、自动代码生成流水线、合规审计机器人、多步协同Agent工作流……111分钟的服务停摆,实则是产线级中断。状态页底部那句看似轻描淡写的提示语——“OpenAI挂了?自动把请求路由到健康的替代模型”,恰恰折射出一个新兴市场现实:多模型容灾能力,正在成为可交易的技术服务。
对企业技术选型而言,这连续17天的波动记录,正将一个关键指标推向决策中心:SLA(服务等级协议)。模型能力排行榜每周更迭,而可靠性却以“天”为单位被持续检验;能力差距可用百分比衡量,宕机损失却是实打实的100%归零。
由此可合理预见两个趋势:其一,多云+多模型智能路由机制,将从架构优化项升格为企业级AI基建的强制标配,单一供应商依赖所隐含的风险敞口,亟待重新评估与定价;其二,每次海外头部平台出现大规模故障,都将成为国产大模型承接外溢需求的战略窗口——前提是,自身稳定性必须率先经受住同等规模流量与复杂度的持续考验。
OpenAI工程团队预计将在数日内发布详细根因分析。但摆在所有人面前的事实已然清晰:连续17天无完整正常日,这个数字本身,已远超一句“错误率升高”所能解释的范畴。