





NotebookLM能自动识别多份资料中的观点冲突并标注证据强度,但需规范上传、显式引用锚点(如@doc1)及验证溯源,否则易产生模糊反馈。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
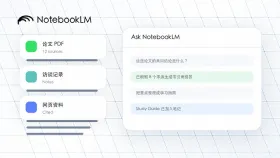
你需要从多份资料中快速揪出相互矛盾的观点,而不是手动比对几十页文档逐字找分歧点。NotebookLM能自动识别冲突、标注证据强度、指出分歧根源,但必须用对方法,否则它只会给你模糊的“有些资料说法不同”这种无效反馈。
上传与预处理:确保资料可被交叉引用
点击「+ New Notebook」创建新笔记本,命名时建议包含主题+时间(如“AI伦理争议_2026Q2”),避免后期混淆。
上传至少两份结构清晰的资料:PDF需含可选中文本(扫描件必须开启OCR)、Google Docs需已共享为“任何人可查看”、网页链接要指向正文内容而非导航页。
【单份资料超过100页或含大量图表时,务必在上传后点击右侧工具栏的「Reprocess source」按钮】——默认解析可能跳过附录、脚注和图表说明,而这恰恰是观点冲突最常藏身的位置。
等待状态栏显示“Ready”后,不要直接提问。先点击任意一份资料缩略图→右上角「⋯」→「View source details」,确认每份文档都被分配了唯一标识符(如@doc1、@doc2),且页码/段落编号与原文一致。
触发冲突识别:三类精准指令模板
方法一:基础冲突扫描(适合初次筛查)
在对话框输入:“请列出所有资料中关于[具体议题,例:算法偏见是否可消除]的相互矛盾陈述,按资料来源分组呈现。”
方法二:证据强度驱动对比(推荐用于学术写作)
输入:“比较@doc1第4.2节与@doc2第7页对[同一结论]的论述。若观点冲突,请用三栏表格呈现:① 分歧点;② 各自证据类型(实验数据/案例分析/专家断言);③ 证据强度评级(强/中/弱)。”
方法三:根源归因模式(适用于政策研判或产品决策)
输入:“找出@doc1、@doc2、@doc3中所有关于[核心变量,例:用户隐私让渡意愿]的矛盾判断。对每个矛盾点,分析导致分歧的潜在原因:理论框架差异?样本选择偏差?时间背景变化?还是隐含价值前提不同?”
注意:指令中必须显式写出@docX格式锚点,不能只说“第一份文件”“第二篇报告”——NotebookLM无法自动映射模糊指代。
验证与精修:防止误判的关键操作
第一步:检查引用溯源是否激活
生成结果中每个观点后应带蓝色超链接(如@doc2:para12),点击必须跳转至原文对应位置。若无链接或跳转错乱,说明该回答未启用引用机制,需重发指令并强制添加“请严格基于原文引用生成”前缀。
第二步:人工校验冲突真实性
对表格中列为“分歧点”的条目,手动打开@doc1和@doc2原文,核对上下文——有时表面矛盾实为术语定义差异(如A文用“bias”指统计偏差,B文指道德失衡),NotebookLM可能未识别语义鸿沟。
第三步:导出冲突摘要
点击右上角「Export」→「Plain text」,复制结果到本地文档。此时务必删除所有“可能”“似乎”“倾向于”等弱限定词,替换为确定性表述(如将“可能源于方法论差异”改为“源于抽样框架不同:@doc1采用全国随机抽样,@doc2仅覆盖一线城市用户”)。


