





一家公司每月支付给 ai 供应商的费用,竟超过了全体员工薪资总和。ceo 的应对方式干脆利落:全面弃用 claude。
Flo Crivello 在 X 平台分享的这张截图,正是这一决策的现场记录。没有情绪渲染,没有战略宣言,只有一句简洁直白的声明:“Pulled the trigger today and switched 100% of Lindy traffic to DeepSeek v4.” 紧接着补充道:“Saves us millions of $ and we're actually seeing an increase in performance on many core use cases.”
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
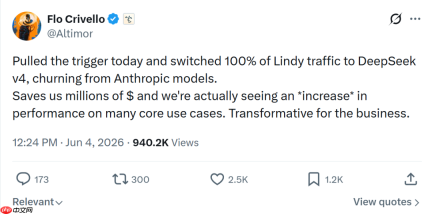
这家总部位于旧金山、员工仅数十人的公司,将全部业务负载从 Claude 迁移至 DeepSeek。直接动因,是 AI 推理账单已高过人力成本总支出。
该事件发生于近一个月前,而其影响直到六月底才真正显现。6 月 27 日,DeepSeek 开源 DSpark 投机解码框架,推理速度提升达 60% 至 85%;同期上线的还有 Wayfinder Router——一款完全离线的智能模型路由工具,可在微秒级内自主判定请求应由本地模型还是云端 API 承载。
Lindy 先行一步,基础设施随后到位。企业不再愿为“大脑”支付溢价,转而寻求能高效执行任务的“肌肉”。
账单压过工资
Lindy 的切换并非仓促之举。Crivello 早在四月就公开指出,公司 AI 推理支出已超过 payroll。团队历时六个月左右评估,期间还测试了 Kimi K2.5 和 GLM-5.1 等多个候选模型,最终选定 DeepSeek v4。
迁移工作量远超预估。Crivello 原话是:“100x more work than we thought.” 大量在线 A/B 测试、离线基准验证、渐进式灰度发布、用户留存监测、提示词适配……整套流程耗时耗力。真正促成最终决定的,是实测结果。
在邮件分类、按用户语调自动生成回复等 Lindy 核心场景中,DeepSeek 表现超出预期。但 Crivello 也未夸大其词:面对高度复杂的自动化流程,Claude 仍具优势。
切换完成后,AI 成本曲线呈现“断崖式下滑”。Crivello 形容道:“You should see our AI cost curve right now. It's a cliff.”
人们自然会疑惑:Claude 是公认的顶尖模型之一,换成更低价的 DeepSeek,为何性能反而提升?答案其实清晰。对邮件处理、日程协调、高频重复类自动化等典型企业级任务而言,过度庞大的参数量只会拖慢响应、抬高开销。DeepSeek 针对这类场景做了定向优化——不盲目堆叠参数,专注提速与落地实效,因此在大量真实业务中实现了“更便宜、更快、更稳”。
Lindy 的个案是否具备行业普适性?坦白讲,尚难定论。它属于典型的 AI 原生应用,成本结构与大型科技公司截然不同。但值得注意的是,6 月底发布的 Wayfinder Router,恰恰瞄准同一痛点:协助企业在本地模型与托管 API 之间自动选择最具性价比的路径,决策延迟以微秒计,全程离线运行。若仅 Lindy 一家遭遇此类困境,这类工具 unlikely 在此时集中涌现。
推理提速六成
DeepSeek 开源的 DSpark 并未推出新模型。它基于 V4 现有权重,新增一个草稿生成模块,通过半自回归机制实现无损加速。实际生产环境中,V4-Flash 与 V4-Pro 的单用户生成速率分别提升 60%–85%、57%–78%;离线测试显示,其可接受输入长度比 Eagle3 高出 26%–31%。
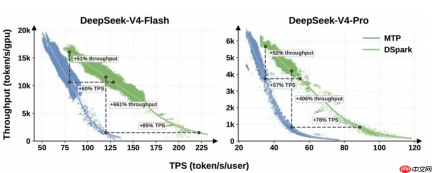
简言之,它并未让模型变得更“聪明”,而是让原有模型跑得更快、更省。对企业而言,这意味着同等硬件资源可支撑更高并发量。成本敏感型组织正需要这样的能力。

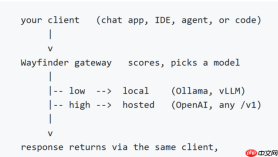
Wayfinder Router 的设计逻辑更为务实。它依据提示词结构特征(如长度、标题、代码块存在与否),在微秒级完成本地模型或云端 API 的路由决策,全程无需调用额外模型辅助判断。过去企业依赖人工配置或第三方服务来“选模型”,如今一个轻量离线工具即可搞定。
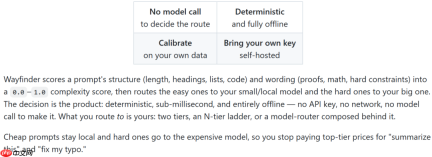
这两项工具均于六月底发布,一个主攻“跑得更快”,一个聚焦“花得更少”。它们不追求“最强智商”,只锚定“够用且经济”。
当整个行业不再为“参数翻倍”集体欢呼,转而为“速度提升 60%”、“成本减半”热烈鼓掌时,AI 就真正从实验室迈入商业战场。
各司其职
Anthropic 的 Claude 实力毋庸置疑。代码生成、复杂推理、安全合规等方面,始终位居第一梯队。Lindy 自身也承认,在深度 workflow automation 场景中,Sonnet 依然更具优势。
但像 Lindy 这样主要用 Claude 处理邮件撰写、日程管理、常规自动化任务的企业,其账单中相当一部分,实则为“未被使用的高级能力”买单。
五月份 Vercel AI Gateway 数据显示:DeepSeek 的 token 流量占比从不足 1% 跃升至 17%,但收入占比几乎未变。这说明它承载的多为低价高频的“体力型任务”。企业并未放弃 Claude 来承担最难的推理工作,只是将“基础层事务”交由更经济的模型处理。
企业在完成成本核算后,开始走向模型分层使用:高难度推理、强逻辑链路、合规严苛场景,继续依赖 Claude;高频低复杂度、延迟敏感、预算紧张的任务,则迁移至 DeepSeek。两类模型分工明确,互不替代。
这种分层背后,折射出两条发展路径的分化。美国企业持续向“更聪明”演进,Claude、GPT 在顶级推理能力上不断加码;中国企业则另辟蹊径:压降价格门槛,让中小企业真正用得起。DeepSeek 的策略非常清晰——不在“大脑”层面硬刚,而在“肌肉”层面做到极致。Lindy 能顺利完成切换,正得益于中国在底层基础设施上的长期投入。
DeepSeek 的崛起印证了一个事实:并非所有企业都需要顶级模型包揽全部任务。当 Lindy 发现迁移后核心指标不降反升、成本骤降,那些只需“够用”的组织便会重新审视投入产出比。
结语
过去,企业选用 DeepSeek 往往带着“退而求其次”的妥协感;如今,Lindy 的主动迁移标志着一种新现实的来临:当开源模型的速度逼近闭源方案,而价格仅为几分之一时,“性价比”本身便成为最不可忽视的核心竞争力。
Lindy 后台那条断崖式下坠的成本曲线,所记录的不只是供应商更换,更是一家美国公司在理性计算之后,对中国技术基础设施的真实认可。
AI 正在分裂为两条轨道:美国向上攀登,精雕 Claude 与 GPT 的“大脑”,冲刺智力天花板;中国向下扎根,夯实 DeepSeek 的“道路”,拉平全球应用门槛。二者并无胜负之分,只有角色分工。对企业而言,在这场由狂热转向理性的下半场中,让每一份算力都精准落在关键环节,远比拥有最聪明的模型更重要。



