





给定一张截图,ai 就能为你自动产出对应代码,这早已不再是前沿黑科技。
真正的挑战,在于让生成的代码真正“跑得通”、 “点得动”、 “验得了”。
传统意义上的“文本生成代码”(text-to-code)高度依赖自然语言描述,但文字在表达空间布局、层级关系与交互逻辑方面天然受限——一张界面截图所承载的信息,常常需要数百字甚至上千字才能勉强还原。而在前端开发、数据可视化、工业设计等场景中,视觉输入反而更直观、更完整、更具语义密度。随着多模态大语言模型(MLLM)能力持续突破,能够同步理解图像、界面、图表乃至动态行为的“多模态代码智能”(Multimodal Code Intelligence)正加速走向实用化。
围绕这一技术范式,美团、香港大学、香港中文大学及多方合作团队联合发布最新综述论文,系统梳理了该领域的核心任务类型、现存瓶颈与关键挑战,并前瞻性地提出 4 个亟待突破的未来研究方向。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/389941c918cb59ff6ff1d1f2ac57cc92
他们强调:以 IWR-Bench 基准为例,当前模型在视觉层面的复现精度已达 64.25%,但涉及真实用户交互的功能正确率却仅有 24.39%。更重要的是,多模态代码智能的评估不能止步于“长得像”,而必须深入到语义一致性、结构合规性、运行可执行性与交互鲁棒性等多个维度。
相关实验代码、评测工具与基准数据集均已开源至 GitHub。
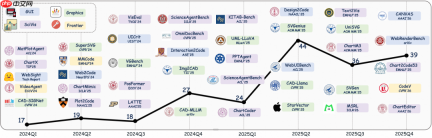
当前进展
在任务建模层面,研究团队将多模态代码智能的核心任务划分为两大主线:
其一是多模态驱动的代码合成,即在图像、界面截图或图表等视觉信号引导下完成代码生成、增量编辑与质量精炼;
其二是以代码为中枢的推理与行动闭环,即把代码视为中间表示,支撑推理决策、工具调用与 Agent 自主执行,而非仅作为最终交付产物。
据此,他们将现有工作归纳为以下四大典型方向:
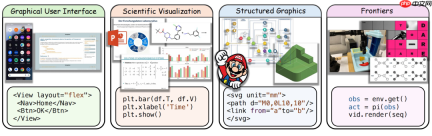
图|多模态代码智能领域全景概览。
GUI 生成方向:网页端代码生成具备最清晰的验证路径(DOM + 行为 + 状态),但当前主流评测仍过度聚焦静态视觉相似度。IWR-Bench 测试表明,模型视觉保真度达 64.25%,而真实交互功能通过率仅为 24.39%;移动端则因缺乏统一仿真环境与标准手势协议,评测体系尚难统一。
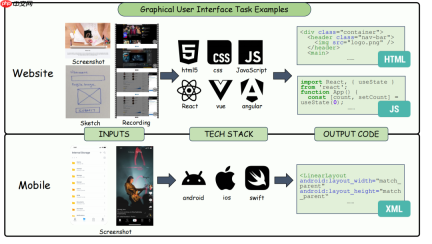
图|网站与移动应用中的 GUI 代码生成任务示例。
科学可视化方向:关键不止于图形渲染正确,更要求代码准确映射数据语义、文档逻辑、实验流程或学科机制,例如图表是否反映真实统计关系、演示文稿是否遵循教学认知顺序、科学动画是否符合物理演化规律。
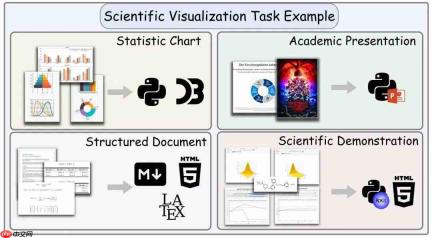
图|科学可视化代码生成任务示例,涵盖图表绘制、学术文档生成、教学演示构建与机制模拟脚本。
结构化图形方向:目标从像素级还原转向结构级保真——SVG 需保持节点可编辑与样式可继承;流程图须保留控制流拓扑与语义连接类型;CAD 模型则需重建参数化建模历史、几何约束链与特征依赖关系。
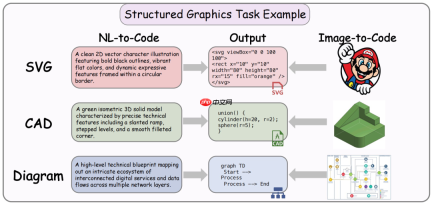
图|结构化图形生成任务示例。
前沿拓展方向:推动代码角色从“输出结果”升级为“推理载体”与“行动接口”,覆盖程序化图像编辑、视频脚本生成、具身机器人控制、视觉驱动编程交互,以及支持跨模态统一表征的通用代码生成框架。
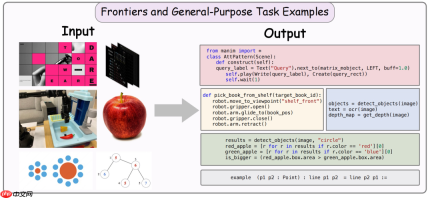
图|前沿任务与统一框架示意图,含程序化视觉操作、视频生成、具身控制、视觉编程交互及多模态统一建模。
未来方向
随着任务边界不断向实时交互、状态演进与物理执行延伸,现有评估范式已显乏力。
基于此,研究团队提炼出四个关键演进路径:
1. 多信号联合验证(Multi-Signal Validation)
单一指标极易误导判断:高视觉相似度 ≠ 正确 DOM 结构;低编辑距离 ≠ 可编译运行;偏好打分往往只捕捉局部风格特征。
因此,下一代评估不应仅输出一个综合得分,而应生成一份多维诊断报告,分别量化:视觉保真度、运行成功率、文本语法与语义合规性、数据/逻辑保真度、结构有效性、可编辑性、交互响应正确性等。同时,评估设计需明确标注各维度所优化的目标属性、所采用的验证器类型,并严格区分训练阶段的奖励信号与部署前的可靠性审计。
2. 多状态过程验证(Multi-State Verification)
对涉及状态变迁的任务(如 GUI、科学演示、视频、具身控制),不能再以“静态快照”为唯一评判依据,而需嵌入完整执行生命周期进行检验。
例如:一个网页可能初始渲染无误,但在点击按钮、切换路由、响应缩放或更新表单时暴露出状态管理缺陷;一段科学演示代码虽能运行,却错误呈现了因果机制;视频脚本可能关键帧精准,但事件时序错乱;具身程序或许抵达终点,却在接触力学、遮挡感知或关节限位条件下失效。
因此,未来基准需覆盖全链路状态轨迹:包括初始观测、生成动作/代码、中间环境反馈、预期状态跃迁、验证器判定结果,以及异常恢复案例。具体而言:网页任务需断言 DOM 树与 React/Vue 状态;移动任务需结合手势轨迹回放与模拟器传感器反馈;视频任务需做帧级时序对齐验证;具身任务则依赖物理引擎输出与控制器日志联合诊断。
3. 跨任务迁移能力测试(Cross-Task Transfer Testing)
评估统一多模态模型时,不应仅关注其支持的任务种类数量,更要检验其底层能力是否具备跨任务泛化性。真正的进步不在于“会更多任务”,而在于是否习得了可迁移的通用能力,例如空间布局推断、符号关系建模、交互意图识别等。
为此,需构建标准化的迁移评测协议:对比基线模型、经源任务增强的模型、以及针对目标任务微调的专用模型,同步报告正向迁移增益与负向迁移干扰。例如:验证图表理解训练是否提升布局解析能力;文档结构学习能否迁移到流程图生成;交互监督信号是否增强代码修复鲁棒性。
4. 可审计 Agent 执行轨迹(Verifiable Agent Traces)
面向 Agent 的视觉-代码系统,不能仅以终态成败论英雄。若缺乏过程证据,便无法判断成功是否源于视觉理解、代码生成、环境执行还是偶然巧合,更难定位失败根源。
研究团队呼吁建立“Agent 证据日志”(Evidence Trace Log)机制,每条轨迹至少包含:所依据的原始观测(截图/视频帧)、引用的视觉区域坐标或工具返回值、执行的代码修改或动作指令、预期改善的验证器指标、实际回放结果,以及证据不足时触发的回退策略。
此类日志不仅支撑轨迹回放、模块消融、反事实扰动、权限分级、沙盒隔离与人工复核,更能将故障精准归因至视觉编码、代码生成、环境适配、验证器偏差或动作策略任一环节,使多模态 Agent 系统摆脱“黑箱依赖”,迈向可追溯、可归因、可干预的新阶段。
一些关键挑战
研究团队指出,当前多模态代码智能的最大制约,并非生成能力本身,而是缺乏坚实可靠的验证基础设施。现有评测普遍依赖单一视觉信号,难以覆盖:
- 网页任务中,单张截图无法验证点击跳转、状态持久化与响应式行为;
- 图表任务中,渲染外观一致不代表数据映射准确、统计逻辑无误;
- SVG / 流程图 / CAD 任务中,像素接近可能掩盖拓扑断裂、语义错连或参数失配;
- 视频 / 机器人任务中,“任务完成”不等于时序合规、物理可行或安全可控。
此外,数据集构建标准不一、评测指标碎片化、任务定义模糊等问题,导致方法间横向对比困难;数据泄露、基准过拟合与评测敏感性进一步削弱结论可信度。
最后,他们警示:多模态代码智能虽有望大幅降低视觉编程门槛,但若验证机制缺位,可能引发一系列现实风险——如网页交互崩溃、图表数据失真、工程图纸结构错误、科学机制误表达、机器人动作越界等。同时,原始截图与设计稿常含隐私信息,生成代码也可能在专有平台中被不当复用或逆向提取。
本文源自微信公众号“学术头条”(ID:SciTouTiao),作者:学术头条,36氪经授权转载。


