





前段时间,google宣布正式面向第三方数据中心及客户直接销售自研tpu芯片及配套ai算力硬件。作为google在ai领域的“核心引擎”,过去第三方仅能通过google cloud租用tpu资源,业内普遍认为其芯片不会对外出售——直到今年6月,这一重磅消息如期而至。
那么问题来了:什么是“TPU”?全称为“Tensor Processing Unit(张量处理器)”,它并非通用型计算单元,而是专为AI任务中高频出现的“矩阵与张量运算”深度定制的ASIC芯片,可在单位能耗下实现远超传统架构的计算效率。
听起来像协处理器?实则不然。当前主流大模型的本质,正是海量数据驱动下的大规模线性代数运算(尤其是矩阵乘法)。正因如此,Google构建了由数千颗TPU组成的超大规模集群,并借助CPU主机完成任务调度、数据预处理与流程编排,从而打造出高度优化的端到端AI算力基础设施。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
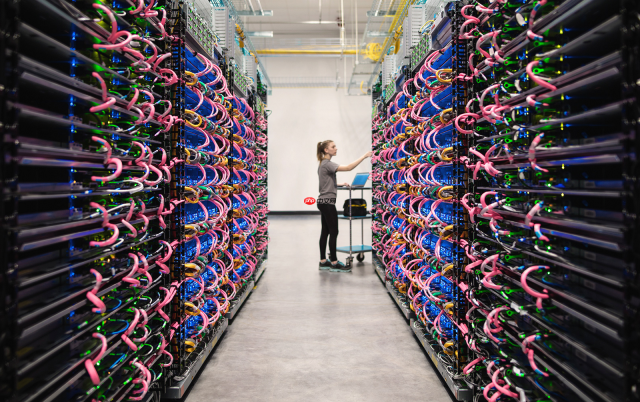
图源:Google
这也解释了为何Gemini系列模型能在订阅价格更低、使用配额更高的前提下,持续吸引OpenAI等竞品用户。单论token单价,Gemini已是海外主流AI产品中旗舰模型定价最具竞争力的代表之一,其主流模型费率亦与DeepSeek等国内头部厂商基本持平。
此外,TPU在应对高频、低延迟、高并发的日常推理请求方面优势显著,与未来以智能体(Agent)为核心的AI生态高度契合,因此外界对这套硬件体系早已翘首以盼。在公布销售计划的同时,Google还披露了一项总额50亿美元的合作协议——将携手黑石集团共建一座大型AI算力中心,初期规划容量达500兆瓦。
雷科技(ID:leitech)推测,该消息发布后,主动接洽Google寻求报价或合作的企业数量可观,尤其是一批正加速推进自有算力中心建设的科技公司。此时或有人担忧:亚马逊云是否会因此承压?事实上,真正面临结构性挑战的,或许是英伟达。
Google给英伟达来了一记“釜底抽薪”?
先抛出一个问题:英伟达为何能在AI浪潮中跃升为全球关键基础设施供应商?若仅归因为“GPU性能强”,那只答对一半。
英伟达真正的护城河,在于早已超越硬件本身——CUDA生态、NVLink高速互连、DGX系统、InfiniBand网络、AI软件栈、开发者工具链、服务器OEM联盟、云平台适配能力……这些要素共同编织成一张成熟、稳定、被广泛验证的AI技术网。
当你插入一张英伟达显卡并启动训练任务时,你购买的不仅是一块芯片,更是一整套开箱即用的AI生产力体系。对绝大多数企业而言,沿用CUDA意味着避免重复造轮子,大幅压缩研发周期与试错成本。
这也是为何许多AI团队明知道英伟达硬件溢价明显,仍选择坚守其生态——在AI爆发初期,“速度”压倒一切,“成本”常被搁置一旁;但当大模型从实验室走向规模化落地,效率与单位算力成本便成为新的胜负手。
Google显然洞察了这一趋势,于是押注TPU,并将其封装为可交付、可部署、可集成的一站式AI基础设施方案。它的目标并非在峰值算力上碾压英伟达,而是将Google多年积累的芯片设计、数据中心架构、网络优化、存储调度与模型工程经验,转化为客户可直接调用的“即战力”。
这才是Google真正向英伟达学来的精髓:不止卖芯片,更要卖系统、卖生态、卖生产力。对于渴望掌握算力主权、构建自主AI底座的企业而言,这种“交钥匙式”解决方案具备极强吸引力。
那么,英伟达是否就此危矣?尚不至于,但压力确已真实浮现。毕竟高端训练卡虽利润丰厚,但客户采购节奏终将回归理性——当性价比成为刚需,Google TPU这类专用方案势必侵蚀其部分中长期市场空间。
不过必须承认,英伟达目前仍是AI算力事实标准,CUDA生态的广度与深度,绝非一代芯片迭代所能撼动。尤其在大模型训练环节,大量团队已在NVIDIA平台上沉淀多年工程实践,贸然迁移风险极高。
例如DeepSeek最新发布的模型,虽支持华为昇腾芯片训练,但也需经历多轮联合调优与生态适配,方得以稳定运行。
图源:昇腾
但站在Google视角,它无需全面取代英伟达——只需精准切入特定客户群,用实测数据证明自身在能效比、推理吞吐、单位token成本等方面的综合优势,便足以在AI基础设施版图中切下关键一块。
尤其是在推理场景,Google TPU服务器展现出明显优势。众所周知,token消耗速度堪比开闸泄洪:Uber曾四个月耗尽全年预算;某神秘企业单月token支出高达5亿美元;微软甚至开始限制员工调用外部API权限,强制转向内部算力池。
随着AI渗透率持续提升,越来越多案例将印证一个现实:token成本,正成为决定AI商业成败的核心变量。谁能把token价格压得更低,谁就能把AI能力更快铺进更多业务线,抢占用户心智与市场份额。
算力变成基本资源,云厂商的机会来了
小雷认同一位网友的类比:训练模型如同买车,推理服务则如每日消耗的燃油——哪怕家底殷实,也不可能长期让所有车辆都加98号汽油;而Google提供的算力,更像是高效经济的92号油:动力足够,任务照做,成本更低。

此前小雷曾撰文指出,行业正形成一项共识:AI算力正加速演变为水电宽带般的基础设施级资源。
对终端用户而言,他们无需了解算力如何生成,却会像关注电费水费一样紧盯token账单——这里的“用户”,既包括个人开发者,也涵盖企业、城市乃至国家级AI平台。
因此,在未来的AI格局中,英伟达仍将不可或缺,毕竟没有高性能芯片,一切皆为空谈。但当算力需求转向长期、稳定、规模化供给时,话语权将逐步向云服务商倾斜。
这也是为何Google、微软、亚马逊、阿里云、华为云等头部云厂商,不再满足于充当英伟达GPU的“渠道商”,而是纷纷构建自有算力生态。这并不意味着它们会停止采购英伟达产品——市场需求与客户偏好决定了多路径并存的现实。
图源:雷科技
但其战略重心,无疑已转向自主可控的底层能力:芯片自研、集群调度、平台工具链、模型服务化、垂直场景优化……这才是英伟达最需警觉的趋势——其当前市值,很大程度上建立在“AI基础底座”的垄断预期之上;一旦其对中端及推理市场的掌控力松动,就可能重蹈五年前游戏显卡市场的覆辙:仍是顶尖,却不再是唯一。
事实上,若将视线投向国内,类似演进早已发生。过去我们讨论国产AI芯片,焦点总在单卡算力对比;但若只盯着这个维度,反而容易忽略更本质的突破:国内云厂商正将芯片、集群、云平台、模型服务与行业方案打包为完整的AI生产系统——这,才是中国AI真正的核心壁垒。
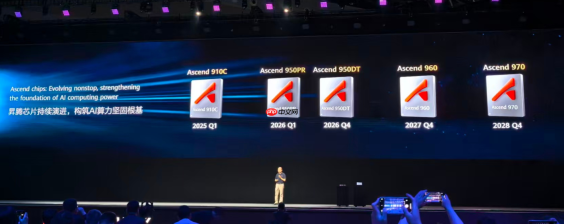
这不是小雷的判断,而是华为云、阿里云等一线厂商正在践行的路径。以华为昇腾为例,虽屡被热议的是芯片性能,但如今华为已围绕昇腾构建起覆盖云化工具链、超节点集群、模型迁移、训推协同优化及千行百业落地能力的全栈体系。
图源:微博
同时,华为正将这套能力开放给更多国产AI力量:除DeepSeek外,百度、科大讯飞、智谱、MiniMax等头部大模型厂商均已深度接入昇腾生态。一套成熟算力体系正在成型,下一步便是聚合生态伙伴,以更具竞争力的token价格打开市场。
阿里云亦步亦趋:今年5月正式发布真武M890训推一体AI芯片;而在此前,真武810E已大规模部署于灵骏智算平台。在刚刚落幕的阿里云峰会上,官方宣布平头哥真武系列AI芯片累计出货量达56万片,年化营收规模突破百亿。
可见,在“学习英伟达”的赛道上,国内云服务商不仅起步更早,节奏也更快。
最强算力?不,全世界需要“最优算力”
当然,Google开售TPU并不会动摇英伟达的短期地位。
至少在未来相当长一段时间内,GPU+CUDA+开发者生态,仍将是AI产业不可绕行的技术主干道——尤其在大模型训练、科学计算与通用AI开发等强算力依赖场景中,英伟达依然是最成熟、最受信任的选择。
但变化已然发生:AI算力市场正迈入新阶段。
过去比拼的是“谁的芯片峰值更高”,如今企业真正追问的,是“谁能让算力更便宜、更易用、更可持续”。此时,Google、华为云、阿里云等拥有海量用户、丰富场景、深厚工程能力的云服务商,其系统整合优势开始全面释放。
换言之,AI时代最稀缺的资源,早已不只是晶体管密度或TFLOPS数值,而是将芯片转化为真实生产力的系统级能力。
当算力日益趋近水电宽带这类基础资源,最终胜出者,未必是单卡性能最强的芯片厂,而是那个能以更低TCO(总拥有成本)、更高SLA(服务等级协议)、更强交付韧性,持续将AI能力输送到千行百业的平台型公司。
因此,在雷科技看来,Google正式开卖TPU,不仅是一次硬件发售,更是一个明确信号:AI基础设施的竞争,已从单一芯片军备竞赛,全面升级为全栈系统之战。
本文来自微信公众号“雷科技”,作者:雷科技,36氪经授权发布。











