





alisa liu 下周即将正式加入 openai。
在此之前,她刚刚走完一段极为密集的求职旅程:参与了 11 家公司的 57 场正式面试,还经历了额外的 46 次招聘沟通,以及拿到 offer 后的 16 轮后续交流。她将这段高强度经历整理成一篇详实的求职复盘,迅速在 AI 领域引发广泛讨论。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
Alisa 在华盛顿大学耗时六年完成自然语言处理方向的博士学业,求职目标聚焦于研究科学家与技术团队核心成员等岗位。按常理推断,这样扎实的学术背景应聘顶尖 AI 企业,面试重点理应落在论文质量、研究深度、模型原理掌握及前沿趋势判断上。但她的复盘却揭示了一个现实:一旦进入正式面试环节,真正被高频考察、反复验证的,仍是编程底层能力。
能否动手写代码?能否独立实现模型结构?能否在类似 LeetCode 的算法题中迅速识别适用的数据结构与解法?这些看似“基础”的能力,依然是绕不开的硬门槛。
评论区中,不少一线 AI 研究者也纷纷分享了相似体验。
Meta 的研究科学家 Mimansa Jaiswal 提到,自己首次全流程面试是在 Anthropic,共经历 9 轮考核,其中两轮 Colab 编程环节表现不佳。她事后才深刻意识到:编程面试绝非临场发挥,必须系统性地提前训练。
另一位来自 Meta 与纽约大学的 AI 研究员 Ravid Shwartz Ziv 也回忆道,多年前他第一次参加公司面试时,面试官布置了几道编程任务;30 分钟后返回,他大脑一片空白,连一行有效代码都没写出来。面试官只留下一句“谢谢,或许下次有机会”,便起身离开。
顶级 AI 公司真正看重的,仍是技术基本功
Alisa 在复盘中披露,她共向 11 家公司投递简历,完成了 57 场正式面试。这还不包括另外 46 次初步沟通、16 次 offer 后的深入交流,以及大量非正式人脉对接。
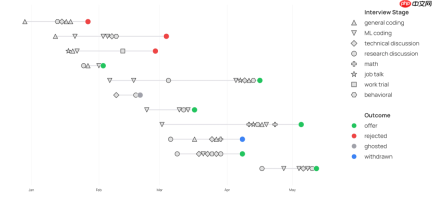
通过这段经历,她对当前顶级 AI 公司的面试逻辑有了更清晰的认知:“整体而言,技术能力与技术知识的权重远高于研究履历——尽管后者往往是获得面试入场券的关键。”
她将面试大致划分为七类:机器学习编程、通用编程、技术讨论、研究讨论、行为面试、数学面试和工作报告。
频率最高的是机器学习编程面试。这类面试强调即时编码能力。题目可能涵盖:从零实现某类模型架构、设计特定解码策略、复现经典机器学习算法,甚至提出更具开放性的工程任务。熟练使用 PyTorch 是基本要求;极少数情况下,面试官会限定仅用 NumPy(例如手写反向传播),但并不要求熟记全部 API 细节,重在逻辑与流程理解。
其次为通用编程面试。本质就是 LeetCode 风格的算法题,偶有变体。
打好基础至关重要,因为许多数据结构与算法概念(如动态规划、图论、哈希表、树、堆、双指针、二分查找)也会渗透进机器学习编程题中。换言之,即便应聘的是 AI 岗位,这些传统 CS 核心能力依然直接影响最终结果。
第三类是技术讨论。无需写代码,但技术密度极高。有时整场面试围绕单一主题展开,例如:如何设计实验验证某个假设?怎样构建系统达成特定技术目标?面试官会持续追问你的设计依据,并让你解读模拟实验结果,进而推导下一步方案。另一些则以快问快答形式进行,比如:“位置编码有哪些主流实现?”“什么是 5D 并行?”“PPO 和 GRPO 的关键差异在哪?”前者检验思维路径,后者考查知识广度与领域熟悉度。
第四类是研究讨论。这是博士生最熟悉的场景。面试官通常先请候选人介绍一项代表性项目,再据此层层深入;也可能延伸至简历中其他论文。准备时需跳出细节,反思:当初为何选择该问题?过程中形成了哪些关键认知?未来哪些方向最具潜力?
她还会依据岗位特性调整研究陈述侧重点——毕竟面试官同样疲惫,若能快速命中岗位关键词,对方更容易判断匹配度。
第五类是行为面试。形式接近标准行为面,但偶有涉及 AI 安全或社会影响的议题。
她的经验教训是:切勿因过往表现良好而轻视此类面试。她首场行为面即告失利——面对常规问题时大脑突然宕机,难以一边回忆博士经历,一边将其组织成符合 STAR 结构的故事。她建议提前梳理博士期间的关键事件,并对应常见行为题型建立素材库,以便临场快速调取。

第六类是数学面试。内容跨度较大,既有趣味逻辑题,也有需纸笔推演的严谨数学证明。她建议重点复习概率论、线性代数与微积分。
最后一类是工作报告(job talk)。相比学术界,工业界 job talk 更精炼、更聚焦。她的汇报主线围绕 tokenizer 展开:主体部分详解一篇一作工作,辅以几项二作及在研项目作为延展,恰好构成一条逻辑自洽的研究脉络。
Transformer 必须练到肌肉记忆,写代码时务必关闭 AI 工具
Alisa 在复盘中强调:面试准备,是最值得倾注时间的投资。
对她而言,这段准备期宛如重返本科:做笔记、画示意图、刷题、泡咖啡馆……只为把机器学习的基础概念真正吃透。技术面试难度极高,且所需能力无法自然从科研经历中衍生,必须在研究之外专门投入精力专项训练。
她说,对她本人及多数同行而言,“找工作本身就是一份全职工作”。
她的备战起点,是斯坦福大学的《Language Modeling from Scratch》课程。
她完整观看所有 lecture 视频,借此厘清自身知识盲区,并将散落脑中的概念重新整合为一张关于语言模型的系统图谱。夯实基础后,她再逐个深挖重点模块:阅读权威博客与论文、与 ChatGPT/Claude 多轮对话探讨、反复练习从零实现各类组件。
她尤其单拎出该课程的 Homework 1。她认为这项作业“不可或缺”,因为 Transformer 实现与调试在面试中出现频率极高;将其练至肌肉记忆,回报巨大,绝不容在此类基础环节失分。
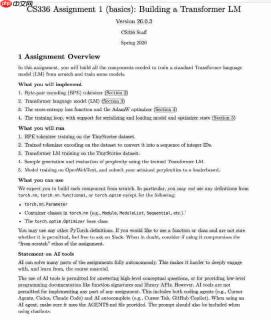
这份 Homework 1 来自斯坦福 CS336 课程,主题正是从零构建一个 Transformer 语言模型——不是调参微调,而是亲手搭建整个链路。
作业要求学生逐层实现所有核心模块。配套仓库 cs336_basics/* 明确声明:“无现成代码可抄,你可完全自主设计实现方式。”
首先需实现 byte-level BPE tokenizer,理解编码原理与子词切分机制,并写出支持训练、编码与解码的完整版本;还需分别在 TinyStories 和 OpenWebText 数据集上训练 tokenizer,对比不同语料带来的压缩效率与词表差异。
接着是从零构建 decoder-only Transformer 模型,涵盖 embedding 层、Transformer block、causal self-attention、RoPE 旋转位置编码、前馈网络及输出头,重点在于张量维度对齐与 attention mask 正确处理。
最后还需实现交叉熵损失函数、AdamW 优化器、完整训练循环,并支持模型与优化器状态的保存与加载,形成最小可行的语言模型训练闭环:原始文本输入 → tokenizer 编码为 token ID → Transformer 训练 → 生成样本 → 用 perplexity 评估效果。
更关键的是,作业对“从零实现”有严格界定:除 torch.nn.Parameter、torch.nn 中的容器类(如 ModuleList)、以及 torch.optim.Optimizer 基类外,禁止直接调用 torch.nn、torch.nn.functional 或 torch.optim 中的高级封装模块。这意味着线性层、归一化、attention、loss、optimizer 等核心组件,都必须亲手编写,不得依赖官方封装“取巧”。
此外,作业虽允许使用 AI 工具辅助理解高层概念或查询函数签名/API 文档,但严禁其参与任何代码编写过程——包括 Cursor Agents、Codex、Claude Code 等编码代理,同时必须关闭 Cursor Tab、GitHub Copilot 等自动补全功能。此前学生反馈表明,关闭 AI 补全有助于更深入掌握底层原理。
这也与 Alisa 的面试建议高度一致。她特别提醒:“练习编码时务必关闭所有 AI 辅助工具,以真实模拟面试环境;否则极易低估自身对 AI 的依赖程度!”
她形容这种备考状态如同一场高强度突击:“每次面试都像一门全新课程——你从未修过,却只有约三天时间准备期中考试。”
参考链接:https://www.php.cn/link/a26d87d40de6192bcf1909654b74c9eb
本文来自微信公众号 “InfoQ”(ID:infoqchina),作者:Tina,36氪经授权发布。








