





宇树的强劲对手智元,再度拆分出一家新公司。
随着觅蜂科技正式宣布完成数亿元天使+轮战略融资,这家由智元发起设立、专注数据能力的独立公司再次进入公众视野。继灵巧手企业临界点之后,智元又一次将自身一项关键能力剥离出来,成立独立实体,并开启市场化融资与运营。
提到智元,很多人第一时间联想到的,便是宇树在具身智能赛道上的头号竞对。
仅看2025年,宇树纯人形机器人实际交付量已突破5500台,对外宣称全球出货量第一;而今年3月,智元则高调宣布其第1万台通用具身机器人正式下线。
从量产节奏到商业化进展,双方始终被置于同一标尺下审视与比较。
而这一次,作为宇树最直接的竞争对手之一,智元正将竞争边界拓展至机器人硬件本体之外。
原因在于,它所分拆出的觅蜂科技,切入的是当前具身智能领域最炙手可热的方向之一:数据采集、治理与流通。其设定的目标也极具雄心——计划于2026年达成千万小时级的数据产能。
基座大模型、算力资源、硬件平台……这些词汇早已成为具身智能讨论中的高频词。但或许更多人尚未充分意识到,“数据”在这一产业中的战略地位,正以前所未有的速度跃升。
就连智元联合创始人、总裁兼CTO彭志辉也曾公开坦言:智元并不缺资金,眼下真正稀缺的是高质量数据。
智元“缺数据”的表象之下,折射出整个具身智能行业正悄然经历一场尚未被广泛察觉、却异常紧迫的“数据饥荒”。
比算力更关键的要素,正在浮现
进入具身智能时代,数据的战略价值,正快速逼近大模型时代的算力地位。
大模型主要学习的是数字世界——网页、文档、代码、论文等均可作为训练语料;而具身智能系统必须理解并适应物理世界。这意味着,机器人需要真实地拿起水杯、推开房门、整理衣物,才能建立对环境、动作与反馈之间关系的深层认知。
机器人所需的数据远不止图像信息,还涵盖触觉反馈、力控信号、关节运动轨迹、多传感器时序同步等丰富模态。每一条高质量真机数据背后,几乎都对应一次真实的物理交互过程。
据觅蜂科技在发布会上披露的估算:训练GPT-5级别大模型所需的语料规模约为百亿小时量级;而目前全球可用于具身智能训练的高质量有效数据,仅有约50万小时。
另一组来自斯坦福大学HAI《2026年AI指数报告》的数据同样耐人寻味:在RLBench仿真操作基准中,机器人任务成功率最高已达89.4%;但在更贴近真实家庭场景、任务链条更长更复杂的BEHAVIOR-1K仿真基准中,完整任务成功率却仅为12.4%。
两项测试虽基准不同,但共同指向一个事实:机器人在短周期、结构化、受控环境中进步显著;一旦面对开放、动态、多步骤的真实生活任务,其能力仍存在明显断层。
而高质量、多样化、覆盖广泛场景的真实世界训练数据不足,正是造成这一断层的关键瓶颈之一。
换言之,今天的机器人,其能力短板很大程度上源于“见过的真实世界太有限”。
因此,具身智能数据采集这一新兴赛道,正加速崛起。
目前主流方式仍是真机遥操作(Teleoperation):由真人远程操控机器人执行任务,同步记录视觉画面、动作指令与系统状态。该方式数据质量较高,但成本不菲、人力依赖强、规模化难度大。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
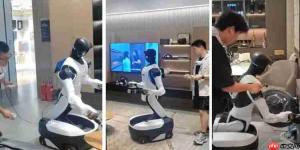
觅蜂CEO姚卯青曾指出,国内一小时真机采集数据的成本通常在500元至1000元之间,且需协调机器人本体、专业操作员与适配场景三方资源,扩张效率受限。
另一条路径是仿真数据生成。企业借助数字孪生与高保真物理引擎,在虚拟环境中驱动机器人完成海量任务训练,从而降低采集门槛。但长期困扰行业的“Sim-to-Real鸿沟”依然存在——虚拟中学到的策略,难以无缝迁移到现实物理世界。
即便数据采集完成,后续挑战才刚刚开始。
各家企业采用的机器人平台、传感器型号、通信协议与数据格式千差万别。同一个“抓取杯子”动作,在不同系统中可能被编码为完全异构的数据结构。大量原始采集数据还需经历清洗、标注、时空对齐、结构化建模等复杂处理流程,方能投入模型训练。
因此,当前多数企业仍停留在“自采—自用—自训”的闭环模式,数据资产高度分散、标准不一、复用率低。
随着数据价值持续凸显,竞争焦点正从机器人本体,逐步延伸至数据采集、治理与流通等底层基础设施层面。
至于行业整体缺多少数据?目前尚无权威统一口径。但可以明确的是,单靠某一家企业闭门造车式的自建采集体系,几乎不可能覆盖通用机器人所需应对的海量真实场景。
谁能率先构建起标准化、可扩展、高可用的数据供给网络,谁就更有可能成为本轮产业爆发中的“卖铲人”。
觅蜂科技瞄准的,正是这一结构性机会。
把数据打造成可调度的平台
当然,数据采集只是起点,觅蜂科技的野心远不止于此。
当前业内高质量数据采集仍严重依赖机器人本体:企业须采购设备、部署场地、招募操作员,并通过遥操作完成采集——其中机器人硬件往往是最大成本项。

觅蜂在保留真机采集方案的同时,推出了MEgo系列“无本体采集”产品,包括MEgo View头戴式采集终端与MEgo Gripper采集夹爪。
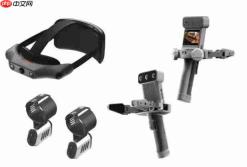
操作员佩戴或手持设备后,即可在超市、工厂、住宅等真实环境中自然记录操作行为,无需机器人全程参与采集过程。
相比传统真机遥操作,无本体采集大幅降低了硬件门槛与部署复杂度,更利于规模化铺开。根据觅蜂披露的规划,其2026年目标产能中,60%至70%将由无本体采集方式贡献。
但采集只是第一步,能否高效治理、转化为可用训练集,才是真正决定数据价值的关键环节。
原始采集数据往往夹杂噪声、冗余帧、无效交互片段,还需完成时间轴对齐、6D轨迹重建、空间感知建模、质量筛选与细粒度标注等多重工序。即使坐拥海量原始数据,若缺乏系统性治理能力,也难以为模型训练所用。
为此,觅蜂将核心研发力量投向数据治理环节。
其自主研发的MEgo Engine数据治理引擎,覆盖数据清洗、6D位姿重建、空间语义建模、质量校验、智能评分与自动化标注全流程。据官方介绍,其自动标注效率较传统人工方式提升超10倍,目标是让采集后的数据更快、更稳地进入模型训练管道。
觅蜂不仅出售原始数据,更致力于提供“从原始数据到训练集”的一站式处理能力。
在更高维度,觅蜂还搭建了数据商城,尝试将零散、异构的数据资源进行标准化封装与接口化输出,面向全行业开放共享。
这一思路与早期云计算发展路径高度相似:云厂商将算力抽象为按需调用的服务,觅蜂则希望将数据本身,也变成一种可交易、可组合、可复用的基础性生产资料。
按公司规划,觅蜂将于2026年实现千万小时级数据产能,并启动“蜂巢数据共创行动”,联合云服务商、场景方及行业组织,力争在2030年前达成百亿小时级数据规模。
这些仍是产能目标,能否如期落地,取决于硬件量产进度、采集网络建设效率以及真实订单转化能力。
但即便如此,资本市场已率先为这套逻辑投票。
今年2月,觅蜂科技完成数亿元种子轮与天使轮融资,由红杉中国领投;
6月再获数亿元天使+轮战略融资,由国方创投领投,多家产业资本与地方国资平台跟投;
阿里云、百度智能云、京东云等头部云厂商亦已与觅蜂签署战略合作,合作内容涵盖数据生态共建、场景协同开发及算力底座支持。
至此,从智元孵化而出的两家公司,已各自锚定不同赛道:
临界点聚焦灵巧手这一关键硬件节点,觅蜂则深耕具身智能的数据底座。
不过,独立融资虽为觅蜂打开了对外服务的空间,却并未天然化解同行对其“中立性”的疑虑。
智元的对手,愿意用觅蜂的数据吗?
觅蜂首先要跨越的,是信任门槛——中立性。
其提出的“蜂巢数据共创行动”,本质是在构建一个跨企业的行业级数据协作网络。但要吸引其他机器人厂商加入,觅蜂必须证明:客户的专属数据不会流向智元,也不会被其他客户越权访问或使用。
姚卯青曾在公开场合回应此问题。他表示,觅蜂的数据交易采用“使用权”与“所有权”双轨制;对于购买数据所有权的客户,公司将完成完整资产交付,并在本地彻底销毁所有副本。
甚至智元若需调用觅蜂数据,也须以市场化方式下单采购,不存在内部免费通道。这些机制至少在制度层面划清了数据隔离的红线。
但要让智元的竞争对手持续采购、长期合作,觅蜂还需通过法律协议约束、权限分级管理、交付审计流程及第三方合规认证,持续夯实其“可信中立第三方”的身份。
毕竟,对智元的竞对而言,选择觅蜂并非唯一解,也不是非选不可。
京东已推出JoyEgoCam采集终端、具身数据基础设施及数据交易平台,并设定两年内积累超1000万小时真实场景视频数据的目标;
鹿明机器人正加速布局无本体采集;
灵初智能主打人类真实操作行为数据;
光轮智能则聚焦合成数据生成与仿真基础设施建设。
它们争夺的,本质上是同一件事:将碎片化的物理世界场景与原始行为数据,转化为可持续供给、可泛化迁移、可迭代训练的高质量数据资产。
觅蜂还需同时应对“规模”与“质量”双重考验。
千万小时目前仅为产能规划,而非已交付成果;无论是真机采集还是无本体采集,扩大规模均意味着持续投入硬件、人力与场景资源。若无法解决数据真实性、多样性与泛化能力问题,再庞大的数据集也可能沦为低质重复。
最终决定觅蜂能否形成正向网络效应的核心变量,仍是同行对其的信任程度。
值得肯定的是,智元推动觅蜂独立融资运营,至少为其争取到了对外服务的制度空间。
倘若数据始终封闭于智元体系内部,最多只能提升单一企业的模型竞争力;唯有经过标准化、商品化,并获得主流机器人厂商的认可与接入,才有望成长为支撑整个行业的新型基础设施。
说到底,对觅蜂而言,“千万小时产能”只是入场券。
唯有当智元的竞争对手们愿意长期向它采购数据、委托数据处理,甚至将核心任务数据交由其托管与治理,这门生意才算真正立住脚跟。
本文来自微信公众号“蓝字计划”,作者:Chester,36氪经授权发布。


