





阿里 ath-token foundry 联合中国人民大学高瓴人工智能学院,今日正式对外发布首个依托统一科学语法构建的多学科科学生成基础模型——logos。该模型采用纯序列建模范式,在六大典型科学任务中,整体性能稳定达到或优于传统领域定制化方法。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
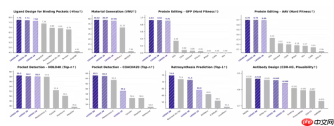
尤为突出的是,LOGOS 展现出卓越的参数利用效率。仅含 10 亿参数的 LOGOS-1B 版本,在多项关键科学任务上的实测结果,已明显优于参数总量达 8×70 亿的微软 NatureLM 模型。
首次实现异构科学对象的语法级统一
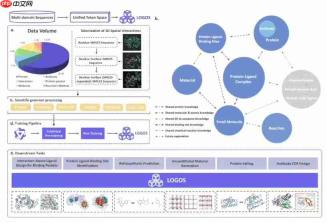
LOGOS 构建了覆盖生物大分子、化学结构及界面相互作用等七大类模态、总计 44.87B tokens 的高质量预训练语料库。通过引入共享词表机制,将蛋白质、小分子等天然异构的科学实体,全部映射为统一离散 Token 序列。
这一创新性的科学语法体系,使不同类型的科学对象可在同一生成空间内被大模型以自回归方式统一理解。更进一步,模型自主演化出一种“文本描述驱动”的建模方式——无需依赖繁琐的三维坐标输入,单靠序列预测即可在隐空间中重建复杂的空间互作逻辑。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
打通预训练与实际科研应用之间的壁垒
在传统科研流程中,不同研究阶段常需切换多个专用模型,导致模型部署时必须进行大量适配性微调。而 LOGOS 实现了预训练目标与下游任务形式的高度同构:其预训练数据的序列结构,与各类下游任务的输入输出格式完全一致。
这种端到端的形式一致性,从根本上弥合了预训练与实际科研落地之间的断层,无需额外设计适配模块即可直接启用生成能力。目前,阿里巴巴已全面开源 LOGOS 的模型权重、推理代码及完整技术报告。











