





人工智能在科研领域的应用正迎来一个关键性拐点。6月18日,阿里 ath-token foundry 与中国人民大学高瓴人工智能学院联合宣布,正式开源一款名为
长久以来,各学科之间横亘着难以逾越的“语义鸿沟”。蛋白质、小分子、复合材料等科学实体,在AI系统中常被视为结构差异巨大、彼此割裂的数据孤岛。为实现它们之间的有效交互,以往方法多依赖高精度3D坐标建模或定制化几何神经网络,不仅算力消耗巨大,而且泛化能力薄弱——一旦任务场景切换,几乎需要从零重构模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
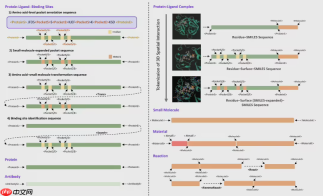
LOGOS 的突破性在于彻底消融了这一壁垒。它构建了一套统一共享的词表体系,将蛋白质、抗体、小分子及MOF材料等异构科学对象,全部映射为标准化的离散Token序列进行编码。换言之,模型不再依赖昂贵且冗余的三维空间表征,而是以类似“阅读文本”的方式,通过序列建模直接推演复杂的三维空间相互作用规律。这套“科学语法”的确立,实现了不同学科底层数据的知识对齐与协同表达。
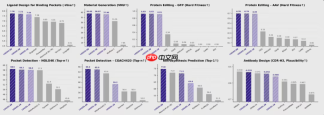
在参数利用效率方面,LOGOS 表现出显著优势。其 LOGOS-1B 版本仅使用微软 NatureLM 约1/56的参数量,却在多项典型科学任务中全面超越后者。更关键的是,LOGOS 成功弥合了预训练目标与下游任务需求之间的“语义断层”,使模型无需复杂微调即可即插即用地激发生成能力,极大降低了科研人员的使用门槛。
截至目前,LOGOS 已建成覆盖7种科学模态、总计达44.87B tokens 的超大规模预训练语料库。项目团队已将全部模型权重、推理代码及完整技术文档全面开源,开发者可通过
这项里程碑式进展,不仅为科研流程自动化注入了强劲动力,更为未来多模态科学大模型的发展开辟了全新路径。随着 LOGOS 的开放,科学世界的“语言体系”或将前所未有地走向统一与高效。











