





更多的机器人示范数据、更庞大的视觉-语言-动作(vla)模型,再叠加一个更精通“物理规律”的世界模型,是否就能通向“通用型机器人智能”?
这正是当下具身智能领域的主流技术路径。然而,一篇最新发布于 arXiv 的立场论文却给出了一个尖锐的反向结论:仅靠这些,并不能实现真正的物理世界泛化能力。
该论文由具身智能数据初创公司 Motoniq 团队联合多位研究者共同完成,直指当前 VLA 模型与世界模型研究范式的根本性短板,系统梳理了物理智能所缺失的四大核心组件,并为构建真正可泛化、可部署的物理机器人智能,提出了清晰的演进方向。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/2e57665b8faf05c967a801eb5aedfa0a
具体而言,通用机器人所欠缺的,远不止是更大规模的动作策略模型;其本质瓶颈在于——缺乏一套能将原始、非结构化的物理交互经验自动转化为高质量监督信号的机制。唯有补齐数据接口、具身接口、世界模型接口与奖励接口这四个关键环节,机器人才能逐步摆脱对人工标注示范数据的强依赖,在真实、开放、动态的物理世界中持续自主学习。
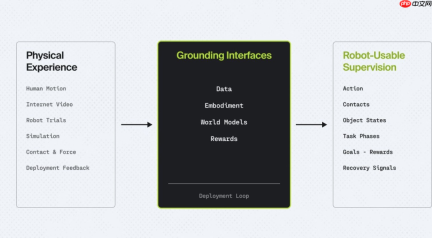
图|从物理经验到机器人可用的监督信号
需要强调的是,这篇立场论文并非否定 VLA 模型或世界模型的价值。相反,它将二者定位为整套物理智能架构中的关键“中间层”,其效能高度依赖底层支撑:即高质量物理数据、具身本体约束、精确动力学建模、任务导向的奖励设计,以及闭环部署反馈机制。
为何现有范式仍显乏力?
研究团队指出,当前具身智能研究主要围绕三类监督来源展开:机器人原生监督、视频弱监督、以及仿真与世界模型驱动的经验生成。三者虽各有进展,但均存在难以绕开的结构性局限:
机器人原生监督:数据稀缺,依赖强标注
当前主流机器人学习仍严重依赖机器人自身采集的结构化轨迹数据,包括观测-动作序列、任务指令、语言描述及成功/失败标签。BridgeData V2、DROID、Open X-Embodiment 等数据集显著拓展了此类数据的规模与多样性,也为 OpenVLA、GR00T N1、Gemini Robotics 等系统提供了训练基础。
但最有效的监督信号,依然来自已充分“接地”(grounded)的真实机器人执行轨迹。动作标签、任务语义和成败判定,往往需在采集阶段手动设定或后期人工标注。这意味着,VLA 模型的能力边界,至今仍被预先整理好的监督数据所框定。
视频弱监督:信息海量,却难解耦为控制指令
互联网上充斥着大量人类操作视频——它们天然包含任务逻辑、物体运动、接触时序等丰富物理线索。但问题在于:这些视频无法直接映射为机器人可执行的动作序列。当前方法多将其作为间接监督源:R3M 用于视觉表征预训练,VIP 用于任务进度建模,LAPA 和 UniVLA 则尝试从中挖掘潜在动作空间,再经适配映射至特定机器人控制域。
然而,视频中蕴含的“潜在动作”不等于明确指令,进度信号未必可直接转化为奖励函数,而人类的操作策略也常受限于人体构型,难以直接迁移到形态迥异的机器人本体上。
仿真与世界模型:加速探索,但物理保真度不足
受限于真实机器人数据采集的高成本与低效率,仿真与世界模型已成为补充训练经验的重要手段。相关工作已从 MimicGen、RoboCasa365、RoboGen 等数据合成方法,延伸至 DreamerV3、V-JEPA 2 等面向控制与交互的仿真探索,以及 ParticleFormer、ContactGaussian-WM 等聚焦点云建模与接触动力学的世界模型尝试。

但研究团队明确指出:当前世界模型的核心缺陷,在于过度关注视觉合理性,而忽视决定控制成败的关键物理变量——如几何形变、物体状态演化、接触力分布、系统稳定性及材料响应特性。若模型在预测中忽略接触关系、质量属性或摩擦系数,即便生成的画面“看起来很准”,其输出也无法作为可信的机器人监督依据。
物理智能缺失的四大支柱
在系统审视上述范式后,研究团队提出:突破瓶颈的关键,不在于一味堆叠模型参数,而在于补全以下四个尚未被充分重视的基础组件:
1. 物理数据引擎与具身自动标注
要让机器人真正利用广泛存在的物理经验(如人类操作视频、可穿戴传感器流、工业产线日志、失败重试轨迹),首要前提是构建一个“物理数据引擎”。当前机器人学习高度依赖人工清洗后的样本,而大量原始物理交互数据——尽管蕴含丰富状态变化、接触事件与因果线索——却因缺乏结构化标注而无法直接使用。
为此,团队提出 “具身自动标注”(Embodied Autolabelling) 范式:即从原始多模态数据中,全自动识别任务起止点、操作目标、接触发生时刻、物态变化过程及最终结果,并完成时间对齐、事件切分与隐状态估计。
此外,人类视频与可穿戴数据不仅可用于任务学习,更是理解人机协同意图与交互模式的重要入口。
2. 跨具身的任务效果保留重定向
跨具身重定向的核心挑战,在于如何将人类演示或抽象物理动作,转化为特定机器人本体可执行、且能复现相同物理效果的动作策略。不同机器人在运动学构型、动力学响应、传感器布局与末端接触特性上差异巨大。因此,重定向不应追求动作形态一致,而应聚焦于保留任务关键物理后果:如目标物体位移量、姿态角变化、接触状态切换、插接过程中的对齐精度等。
3. 物理扎根的世界模型
该类模型的目标不是生成“像不像”的未来帧,而是精准预测动作引发的可操作物理后果:例如抓取后物体是否会滑脱、推拉过程中接触是否中断、抽屉是否因卡滞而无法完全打开。其建模重心应落在与任务强相关的物理维度上——几何约束、接触力场、刚体/柔性体响应、材料形变特性,以及任务进度的量化演化。同时,模型还需具备可靠的不确定性量化能力,以支持安全决策与主动探索。
4. 自我迭代的部署闭环
机器人在真实环境中执行动作后,需依据任务目标实时评估执行效果,这一过程依赖任务条件化的奖励扎根(Task-Conditioned Reward Grounding)。由此,每一次部署轨迹都不再只是“成功/失败”的二元记录,而可分解为进度信号、失败归因、恢复路径与成功验证等多个监督维度,进而驱动各模块的定向优化,形成真正意义上的“执行—评估—改进”闭环。
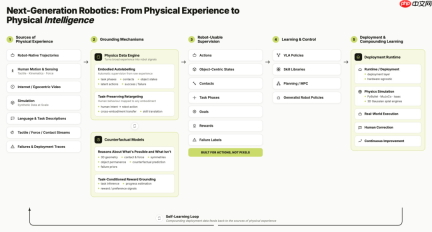
图|下一代机器人:从物理经验到物理智能
未来演进路径
目前,各类物理经验源所提供的监督信号仍是碎片化且不完整的:机器人数据常缺细粒度标签,视频数据缺乏动作映射,可穿戴数据未与特定本体绑定,仿真则受限于物理建模精度。未来的关键方向,在于构建统一的物理数据引擎,将这些异构数据源视为同一底层物理过程的不同观测视角,并将其映射为共享的、结构化的物理语义标签。
研究团队还指出,世界模型的表示范式尚无共识。当前主流方案——像素级渲染、物体中心坐标、点云、网格、神经辐射场(NeRF)、高斯溅射(Gaussian Splatting)等——在建模接触、受力传递与材料响应方面均存在明显短板。后续需发展真正“物理扎根”的表示体系,并强化其不确定性建模能力。
与此同时,跨具身重定向仍缺乏可验证的技术路径。未来工作需从“模仿姿态”转向“复现效果”,即以任务物理目标(如“将螺栓旋入深度达5mm”)而非动作轨迹本身作为优化锚点。
最后,部署中产生的失败案例,往往难以沉淀为精准、可归因的改进信号。未来需建立任务条件化的闭环诊断机制,使系统能自动区分“进度正常”“局部失败”“自主恢复”与“完全成功”,并据此触发对应模块的增量更新,而非简单地启动全模型重训练。
本文来自微信公众号 “学术头条”(ID:SciTouTiao),作者:夏千斯,36氪经授权发布。


