当前,自进化 agent 的持续学习过程,大多依赖成功执行轨迹、预定义技能库或明确的人工反馈。然而在实际部署场景中,这些前提条件往往难以同时满足,导致 agent 难以持续积累经验并实现能力迭代。
为应对这一挑战,里海大学计算机科学与工程系助理教授孙立超团队联合多位研究者提出了 OpenSkill 框架——区别于传统依赖人工标注、大语言模型生成或监督信号驱动的自进化路径,该框架使 Agent 能够在无需目标任务监督信号的前提下,自主习得可执行、可泛化、可迁移的 skills。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文地址:https://www.php.cn/link/018b1d3ea470dbb00e3dd6438af19bfb
实验表明,OpenSkill 在多个权威基准测试中达成了当前最优(SOTA)的自动化性能,所学 skills 还能无缝迁移到能力更基础的模型上。全部代码、数据与模型已在 GitHub 开源,支持免费下载与复现。
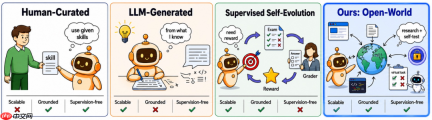
图|自进化 Agent 技能构建范式的演进路径。
OpenSkill 的核心设计思路
OpenSkill 是一个面向开放环境的 Agent skill 自生长框架,其输入包括任务指令、运行环境、基础大模型、可用工具集以及开放世界中的多源信息。整体流程划分为三个关键阶段:开放世界知识采集、无信息泄露的 skill 进化 和 零样本目标评估。
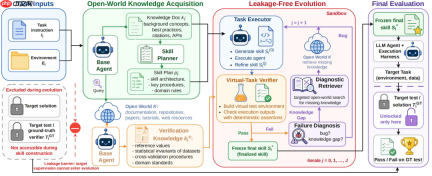
图|OpenSkill 整体架构示意图。
开放世界知识采集:
团队首先从开放网络中主动检索两类关键知识:一是任务导向型知识,涵盖领域背景、API 规范、行业最佳实践及真实代码片段,用于指导 skill 的结构化设计;二是验证导向型知识,包括典型参考值、统计规律、交叉校验逻辑,以及已知的输入-输出对,用以支撑后续虚拟环境下的自动评测。
无信息泄露的 skill 进化:
在获取上述知识后,OpenSkill 自动生成候选 skill,并借助系统自建的虚拟任务环境进行多轮闭环测试、筛选与优化。整个进化过程不接触目标任务的真实标签或标准答案,真实测试集也严格隔离于 skill 构建流程之外,确保无数据泄露。
零样本目标评估:
当 skill 完成进化后,将以独立可加载模块形式部署至目标 Agent。此时,被长期隐藏的真实测试集才首次启用,仅用于最终性能评估,完全不参与任何前期 skill 的生成与调优环节。
实验验证结果
为全面评估 OpenSkill 的有效性,研究团队从 基准性能对比、跨模型 skill 迁移能力 以及 模块消融分析 三方面展开系统性实验,结果如下:
1. 基准测试表现:全面领先现有方法
OpenSkill 在三大主流 benchmark 上、面向两个不同能力层级的目标 Agent(Opus 4.6 与 GPT 5.2),均取得了最高自动化通过率。在 SkillsBench 中,其分别将 Opus 4.6 和 GPT 5.2 的总体成功率提升至 43.6% 与 42.1%,相较最强基线高出 8.9% 和 8.8%,与人类专家水平差距仅剩 1–3 个百分点;其中 Opus 4.6 在 11 个细分领域中,有 8 个达到最优或并列最优。
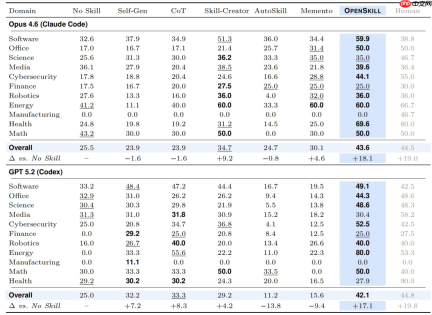
图|SkillsBench 各领域平均奖励得分:对比两个目标 Agent 在 11 类任务上的表现。
类似优势亦体现在其余两项 benchmark 中:在 SocialMaze 上,OpenSkill 对 Opus 4.6 和 GPT 5.2 的通过率分别达 82.7% 与 70.7%;在 ScienceWorld 上则分别达 90.0% 与 85.3%。研究指出,在全部四组实验设置下,OpenSkill 均为当前自动化 skill 学习方法中性能最强者。

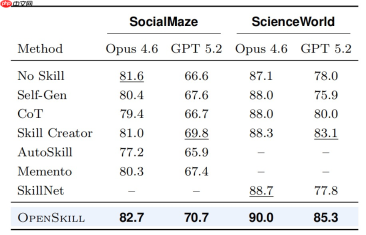
图|SocialMaze 与 ScienceWorld 基准下两个目标 Agent 的平均奖励对比。
2. Skill 迁移能力:即插即用,适配弱模型
在迁移实验中,团队将由 Opus 4.6 训练出的 skills 直接部署至 Haiku 4.5、Qwen 3Coder、DeepSeek V3 和 Mistral Large 3 四款能力较弱的模型,未做任何适配或微调。结果显示,所有目标模型在 SkillsBench 上均获得显著性能增益,提升幅度达 5.5 至 14.8 个百分点。
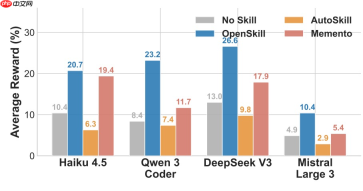
图|Opus 4.6 所生成 skills 迁移至其他模型后,在 SkillsBench 上的平均奖励变化。
3. 消融实验:三轮迭代为最优平衡点
在 SocialMaze 上,OpenSkill 在 3 轮 skill 迭代时达到峰值性能(82.7%),继续增至 5 轮与 10 轮后性能反而下降。进一步消融表明:开放世界知识检索与虚拟验证器机制各自均能带来正向提升,二者协同作用效果最显著。此外,研究发现虚拟验证器与真实评估结果高度一致,覆盖了 88.9% 的真实测试意图,并在格式规范性、类型一致性及边界条件检查等方面提供额外保障。
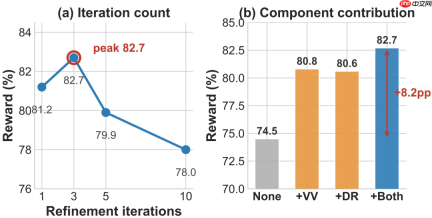
图|SocialMaze 场景下的模块消融实验结果。
局限性与未来方向
研究团队同时坦承当前方法存在的若干限制:
- 开放世界知识源本身可能存在噪声干扰、内容过期或观点冲突等问题;
- 虚拟任务虽具代表性,但尚难完整复现真实任务的语义深度与对抗复杂性,尤其在深层逻辑推理与反作弊元验证方面覆盖不足;
- 整体流程计算开销较大、耗时较长:在 SkillsBench 全部 84 个任务上,端到端 API 总成本约 1800 美元;单任务平均消耗约 1.14M tokens,耗时约 131 分钟。不过,skills 一旦建成即可复用,迁移至新模型时无需重复训练。
团队强调,后续工作将聚焦于:提升外部知识源的可信度与时效性、增强虚拟验证对真实任务语义边界的建模能力,以及系统性压缩计算资源消耗与时延。
更多技术细节请参阅原文。
本文首发于微信公众号 “学术头条”(ID:SciTouTiao),作者:夏千斯,经 36氪 授权转载。