☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
应通过字段语义约束、推导式描述、枚举映射、分步引用和禁用占位符五种方法提升cursor生成mock数据的质量:①为email、id等字段添加生成逻辑;②用“user_id匹配用户列表”“total_amount=quantity×unit_price”建立字段依赖;③status按4:3:1比例限定三个枚举值;④分步生成并显式粘贴前置id;⑤禁止test/demo等占位符,强制使用真实语义值。
你需要让 cursor 一次性生成结构清晰、字段不冗余、示例值不重复的 mock 数据,而不是反复出现 name: "john", name: "alice", name: "bob" 这类低信息量堆砌。
用「字段语义约束」替代自由发挥
直接写“生成10条用户数据”会让 AI 自由填充,极易陷入模板化重复。必须明确每个字段的生成逻辑。
在提示词中为关键字段添加语义说明,例如:【email 字段需基于 username 自动生成,格式为 username@example.com】,这样就能切断 email 和 name 的独立随机生成链,避免两者脱节又重复。
对 id 字段加约束:“id 从 1001 开始递增”,比写“id 是数字”更有效——后者常导致 AI 随机返回 [1, 5, 9, 22, 3] 这类无序值,后续排序或关联时出错。
强制字段间存在逻辑关系
方法一:用“推导式描述”绑定字段
写“生成 8 条订单数据,其中 user_id 必须与前面生成的用户 id 列表匹配,order_date 在 2026-05-01 至 2026-05-30 之间随机,total_amount = quantity × unit_price”——这句话让 AI 理解字段不是孤立的,而是有计算依赖和范围锚点。
方法二:用“枚举+映射”控制取值粒度
例如:“status 字段只允许三个值:'pending'、'shipped'、'delivered',且按 4:3:1 比例分配”——这比“status 是字符串”精确得多,也杜绝了 AI 自创 status: "processing..." 这类偏离业务的值。
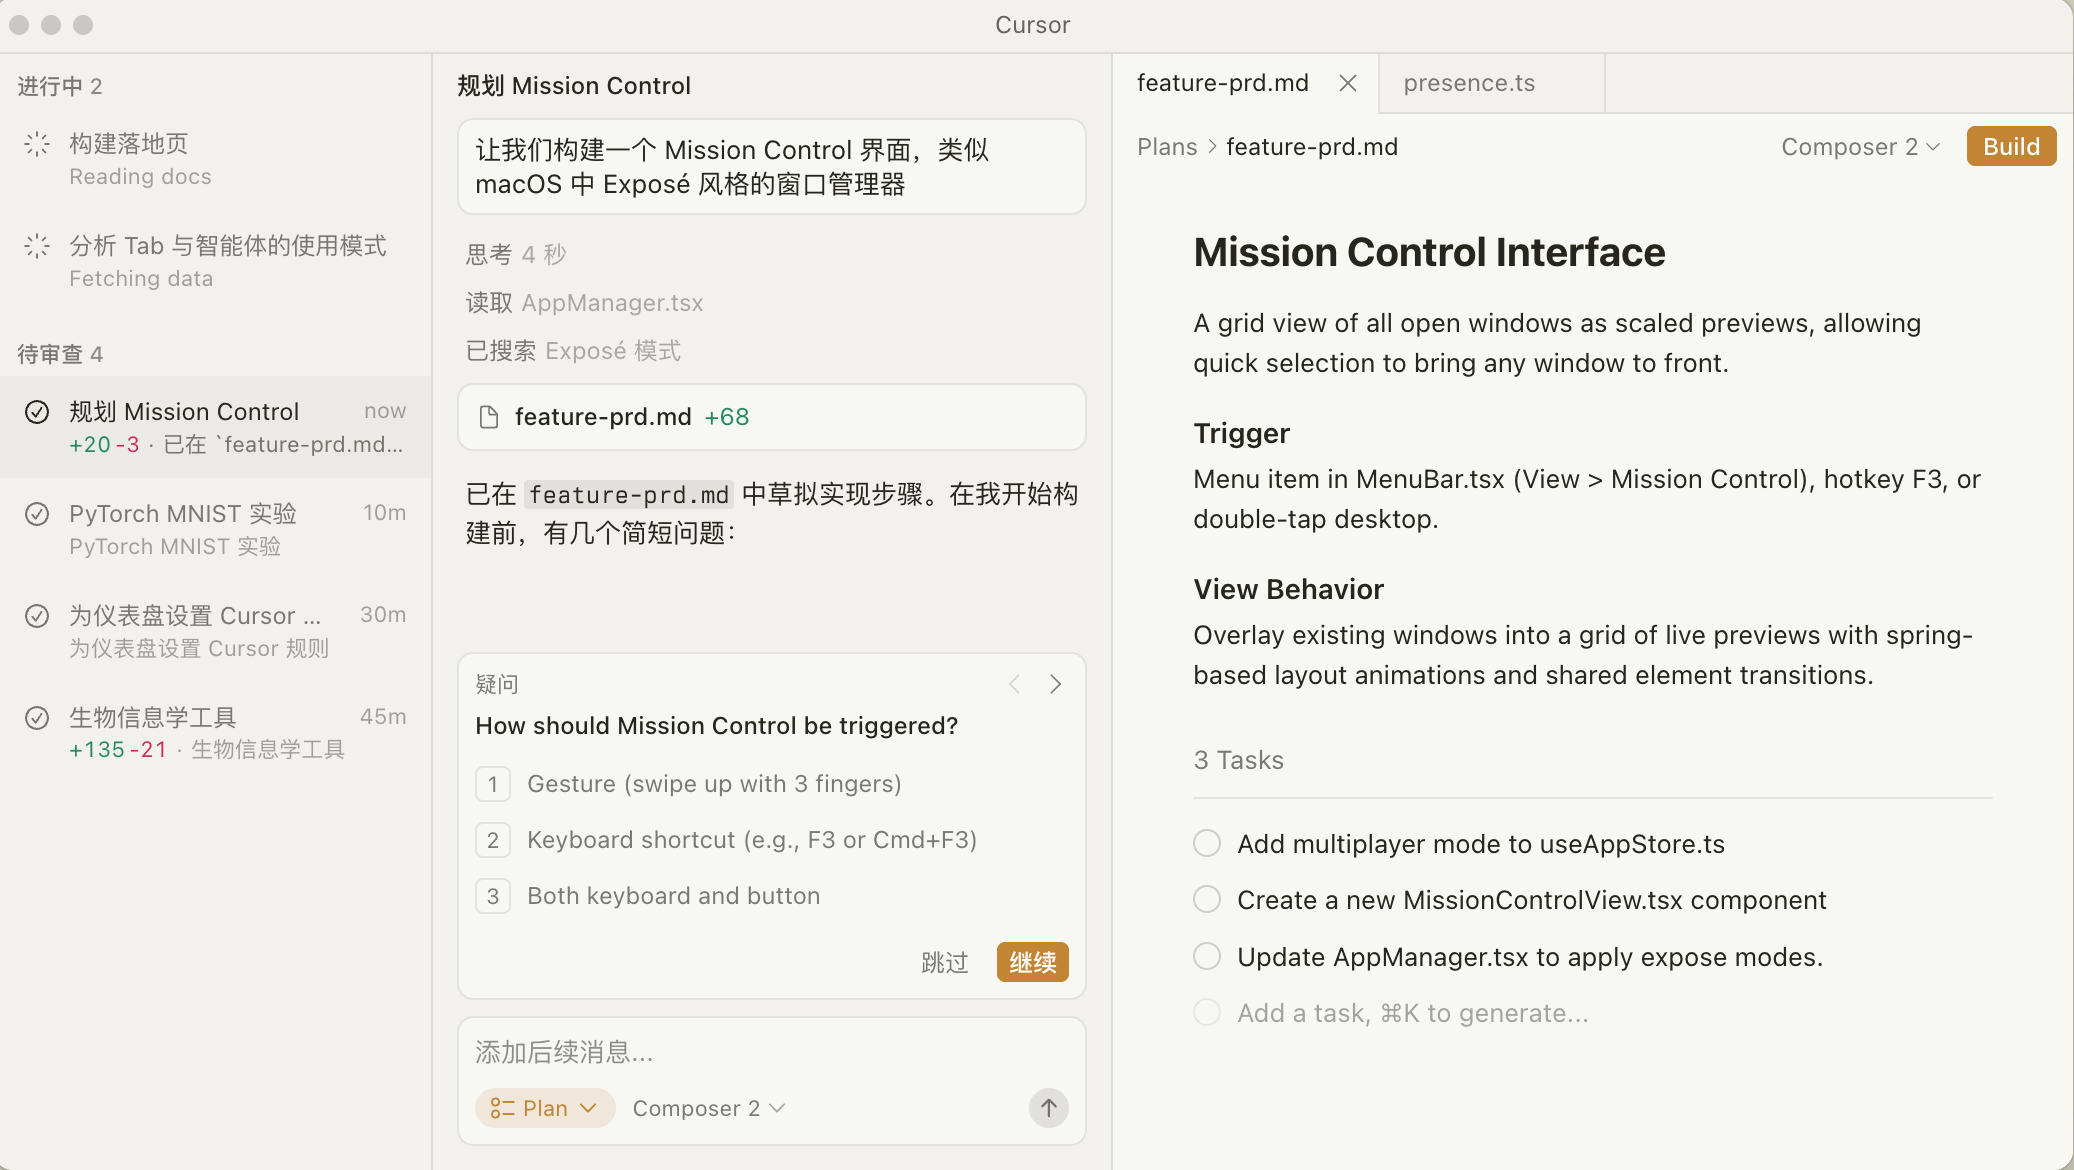
Agents 正在你的整个代码库中处理越来越复杂、运行时间更长的任务。本次版本引入了新的 agent 框架改进,以实现更好的上下文管理,并在编辑器和 CLI 中带来了许多提升使用体验的修复。
分步生成 + 引用前置结果
第一步:生成基础实体(如 users),保存其 id、username 列表到剪贴板或变量名;
第二步:在新提示词中显式引用:“基于以下用户 ID 列表生成订单:[1001, 1002, 1005, 1007],每条订单的 user_id 必须从中选取,且不重复使用同一 ID 超过两次”。
这一步的关键是【必须把上一步生成的 ID 显式粘贴进新提示词,不能只说“用之前的用户”】——Cursor 不会跨对话自动记忆具体数值,模糊指代必然导致重复或编造。
禁用通用 filler 词库
在提示词末尾加一句硬性指令:“禁止使用 'test'、'demo'、'sample'、'xyz'、'abc' 等占位符类单词作为字段值;所有字符串值必须符合现实命名习惯,如城市名用 Beijing、Shanghai,产品名用 iPhone 15、Surface Laptop 5”。
这能立刻过滤掉 AI 内置的默认测试词库,逼它调用真实语义知识生成内容。