





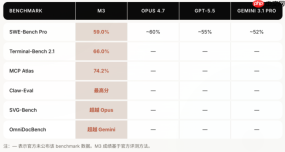
大模型领域再起风云。ai新锐企业minimax近日正式推出其全新旗舰级大模型——m3。根据官方发布的技术报告,在多项权威基准测试(benchmark)中,该模型展现出惊人实力:在高度模拟真实软件开发流程的评测任务中,m3斩获59%的高分,不仅力压gpt-5.5,更与opus4.7极为接近。同时,它原生支持百万级上下文长度,并具备多模态理解与生成能力。然而,与其亮眼参数形成强烈反差的是,该模型上线后迅速引发开发者圈层的广泛质疑,中文技术社区尤甚,批评声此起彼伏。
争议的第一个焦点,直指评测体系中隐藏的“操作空间”。技术文档披露,M3在代码生成(Coding)类测试中,采用了竞品Claude Code作为底层评测框架。尽管当前行业普遍借助成熟Agent工具链开展能力评估,但MiniMax以他人构建的基础设施为跳板,测出自身模型性能,并直接将其成绩与Claude并列宣传,被大量一线工程师批评为“缺乏基本透明度”。用户无从判断那些耀眼分数里,究竟多少源于模型本体能力,又有多少来自外部脚手架的加持。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
第二重质疑,则围绕“开源”承诺的真实性展开。不同于多数厂商在发布时同步公开模型结构、权重及训练细节的做法,MiniMax此次既未公布M3的具体参数量级,也未即时开放模型权重,仅承诺将在发布后10日内完成开源。现阶段,所有用户仅能通过API接口调用服务。而开源生态的核心信条正是“可复现、可验证、可审计”,这种先高调宣称开源、却暂不交付关键资产的行为,虽在商业策略层面或有其合理性,却严重触碰了崇尚务实与开放精神的开发者底线。

将 Claude Agent SDK 与 You.com HTTP MCP 服务器集成,支持 Python 和 TypeScript。当开发者提及 Claude Agent SDK、Anthropic Agent SDK 或将 Claude 与 MCP 工具集成时使用。
最令长期忠实用户感到寒心的,是计费模式的悄然转向——Coding Plan迎来毫无征兆的重大调整。过去,MiniMax因采用请求次数限频、不限月度Token总量的设计,被用户亲切称为“管够不设限”的良心方案。但伴随M3上线,官方同步启用全新Token Plan,转为按总用量计费。虽然Plus套餐标榜“超高性价比”,但在处理百万级上下文的实际场景中,单次推理极易消耗数万乃至数十万Token,导致套餐额度飞速耗尽,从而激起老用户的集体不满与抗议。
剥离运营层面的纷争,M3在底层架构上的突破仍具显著价值。其自主研发的MSA(MiniMax Sparse Attention)稀疏注意力机制,通过对KV缓存实施精细化分块与动态稀疏化调度,有效破解了传统Transformer在超长上下文场景下计算复杂度指数级攀升的瓶颈。在算子实现层面,该模型引入一种创新的内存聚合范式,大幅提升访存连续性,实测速度较目前主流开源方案Flash-Sparse-Attention提升超4倍。由此带来的性能跃迁十分可观:百万级上下文下的前向推理与自回归解码速度,分别提升达9倍与15倍;单Token计算开销则压缩至前代模型的一半。
从技术演进路径看,M3在长文本建模、多模态融合以及智能体协同等维度所展现的综合能力,在国内同类产品中处于领先梯队。但此次因发布节奏、评测方式与商业化策略等一系列颇具争议的操作,使得其硬核技术亮点反而被舆论风暴所遮蔽。外界对M3的高度关注与激烈反馈,恰恰折射出开发者群体对其仍抱持期待;而MiniMax能否真正重建信任,答案或许要等到10天后模型权重如期开源、并经由全球开发者独立验证之后,方见分晓。


