





aibase 报道 5月26日,国际知名编程能力评测平台 code arena 公布最新榜单,阿里巴巴研发的 qwen3.7-max 模型以1541分高分跃居全球第二,稳坐国产大模型编程能力榜首,仅落后于 claude 系列。该成绩一举超越 gpt-5.5、gemini3.5flash 等多款国际头部模型,彰显中国大模型在 agentic coding 及长周期任务处理方向上的实质性飞跃。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
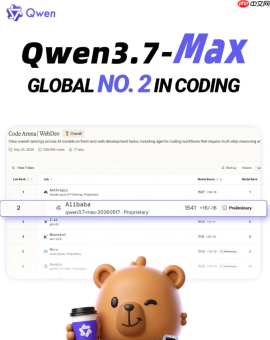
编程综合能力跻身世界前二,国产模型领跑地位再强化
据最新 Code Arena 排行榜显示,Qwen3.7-Max 在贴近真实开发环境的多项测试中表现卓越,尤其在多文件协同编码、逻辑调试、系统级工程构建及跨工具链调用等关键维度上展现出显著优势。AIbase研判指出,该排名已不仅反映模型单次指令响应质量,更验证其在完整软件生命周期中的工程化适配能力——具备直接支撑企业级项目落地的技术成熟度。
面向真实生产:35小时超长时程 Agent 表现惊艳
Qwen3.7-Max 的核心突破在于深度集成的Agent 原生架构,专为复杂、持久、自主型任务而优化:
- 单次任务可持续运行35小时不间断
- 累计完成1000+次精准工具调用
- 将传统需耗时两周的中等规模开发任务,压缩至数小时内闭环交付
模型在操作系统内核调优、跨模块长链路推理等高难度场景中保持高度上下文稳定性与自修正能力,显著降低人工干预频次,切实推动人机协作从“辅助”迈向“共担”。

使用 @youdotcom-oss/teams-anthropic 将 Anthropic Claude 模型(Opus、Sonnet、Haiku)添加到 Microsoft Teams.ai 应用程序中。可选集成 You.com MCP 服务器以进行网页搜索和内容提取。
兼容主流框架,部署成本优势突出
Qwen3.7-Max 具备良好的生态开放性,原生支持多种 Agent 运行框架,并兼容 Anthropic 标准协议,可平滑对接 Claude Code 等现有开发工具体系。与此同时,在算力消耗与响应效率之间实现更优平衡,为不同规模团队提供兼具高性能与低门槛的落地选项。
AIbase认为,Qwen3.7-Max 的推出正加速重构 AI 编程工具的价值边界。无论是快速迭代的前端原型、高可靠性的后端服务,还是端到端自动化的全栈流程,都将迎来新一轮提效浪潮。这一进展不仅惠及国内开发者群体,也为全球 AI 工程化实践提供了具有中国特色的可行路径。
后续,AIbase将持续追踪 Qwen 系列模型的迭代节奏与产业落地实证。Qwen3.7-Max 的进阶表现再次印证:在 Agent 主导的新阶段,真正赢得开发者信任的,是那些能稳定驾驭“长时间、高可信、即上线”三重挑战的大模型——而这,正是下一代生产力革命的核心入场券。



