





近日,李飞飞团队推出的 esi-bench(embodied spatial intelligence benchmark)迅速成为学界焦点。这一评测基准不仅被称作具身智能领域的“imagenet”,更一针见血地暴露了当前顶级大模型在真实物理空间交互任务中的根本性缺陷。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
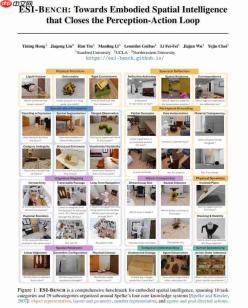
ESI-Bench:为何它重新定义了具身智能的衡量标准?
长期以来,AI 的空间理解能力评估多停留在“被动接收”层面:仅提供几张理想角度的图像,要求模型据此推理。这种方式实质上检验的是模型的“图像识别力”,而非其对三维空间结构、物体关系与动态交互的真实认知。
ESI-Bench 的革命性在于:强制构建闭环式的“感知-行动”链条(Perception-Action Loop)。
- 从旁观者到参与者: 在该基准中,模型无法依赖预设视角“坐等答案”。它必须像人类一样自主规划路径、选择观察点、拾取目标物体、操作机关装置,并通过连续的动作序列逐步揭示被遮挡或隐含的空间信息。
- 理论根基扎实: 其任务设计深度借鉴认知心理学家 Elizabeth Spelke 提出的“婴儿核心知识系统”,涵盖物体恒常性、空间布局与几何关系、数量表征、以及目标导向行为四大认知维度。
- 规模庞大且高度仿真: 涵盖10大类、29个子类、共计3081项具体任务,全部运行于 OmniGibson 仿真环境,场景数据源自 BEHAVIOR-1K 真实家居建模库。
三大颠覆性发现:揭开顶尖模型的“空间盲区”
研究团队对 GPT-5、Gemini 系列等当前最先进的多模态大模型展开系统性测评,结果直击行业痛点:
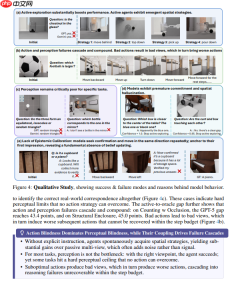
1. 视觉识别并非短板,动作策略才是致命瓶颈
实验显示,当直接给予最优视角图像时,模型准确率可飙升至95.1%(原始仅为14.6%);但一旦切换为“自主探索模式”,性能断崖式下滑。
- 动作失明(Action Blindness): 模型严重缺乏导航逻辑与操作直觉,错误动作导致视野恶化,劣质观测又进一步引发误判,最终形成恶性循环式的连环失败。
2. 不完美的3D重建,可能比2D图像更具欺骗性
该研究有力驳斥了“只要建出3D地图就能解决一切”的技术迷思。

使用 Google GenAI SDK 通过 Gemini 生成或编辑图像。当用户要求在 OpenCla… 中创建、转换、渲染或保存一张或多张图像时使用。
- 若输入理想化的上帝视角3D真值,模型推理表现优异;但若采用当前主流 VGGT 模型进行实时重建,所生成的3D场景往往充斥着几何畸变、遮挡误判与深度误差——这些“带毒”的重建结果,反而比单纯使用2D图像更严重干扰模型判断,使其表现更差。
3. 元认知缺失:AI 不懂得“自己还不知道”
这是人与当前AI之间最本质的认知鸿沟:
- 人类的审慎机制: 面对模糊信息,人类会主动寻找反证视角,并在证据不足时主动降低置信度;
- 模型的幻觉倾向: AI却倾向于过早终止探索,在信息极度匮乏的情况下,仍以极高置信输出确定性结论。研究团队将此现象定义为“元认知缺陷”——即模型缺乏内在的自我评估能力,无法判断当前所获信息是否足以支撑可靠决策。
具身智能的破局之路何在?
ESI-Bench 的诞生,标志着空间智能评测正经历一场范式跃迁:从静态图文匹配,迈向动态物理交互。正如李飞飞团队强调,通往真正空间智能的道路,绝非靠堆叠视觉编码器或提升算力即可抵达。
未来的研究重心,必须转向赋予模型三项关键能力:
- 具备长期规划能力的序列化行动决策机制,超越单帧图像识别的浅层感知;
- 更强的鲁棒性与容错能力,使其能在噪声、遮挡、重建失真等不完美观测条件下维持稳定推理;
- 嵌入式元认知反馈回路,让AI在不确定时主动发起探索,而非制造虚假确定性。
ESI-Bench 不只是一套评测工具,它更像一面棱镜,折射出当前AI在物理世界中的“认知傲慢”与“能力无知”。它不仅是衡量进步的标尺,更是推动具身智能从虚拟界面真正迈入现实空间的一份战略指南。


