





autoresearch 是由 andrej karpathy 开源的一款面向 ai 自主科研的实验框架。该框架使 ai agent 能在单张 gpu 上全自动运行 nanochat 训练任务,涵盖参数调整、训练执行、指标分析与后续优化决策等全流程,彻底替代传统“调参→跑实验→查日志→再调参”的人工闭环。autoresearch 入门门槛极低,支持单卡部署,推动 ai 从被研究对象跃升为可独立开展科研工作的执行主体。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

One API key for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more
下载
统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
autoresearch 的核心能力
- 自主代码演进:AI Agent 可直接编辑 train.py 文件,灵活变更模型结构、优化器类型、超参数设置等训练全链路配置。
- 时间约束型实验:每次训练严格控制在 5 分钟真实耗时(wall-clock time),保障跨设备、跨环境下的结果可复现与可比性。
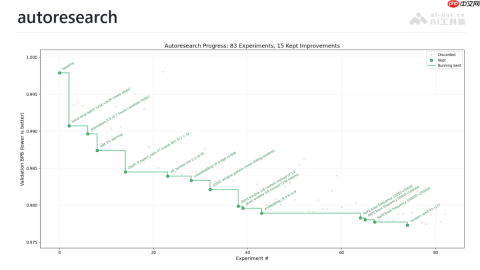
- 效果驱动筛选机制:以 val_bpb(验证集每字节比特数)为统一评估标准,自动保留能降低该指标的有效修改,剔除无效尝试。
- 人类主导的研究编排:通过 program.md 定义 Agent 的行为逻辑与研究策略,人类聚焦于优化“研究流程代码”,而非直接干预训练脚本。
- 极简文件边界:Agent 仅操作 train.py 单一源文件,确保实验影响范围清晰、修改差异(diff)易于审查与理解。
autoresearch 的技术实现原理
- 轻量级 nanochat 训练简化版:基于单 GPU 构建的微型 GPT 模型,集成 Muon 与 AdamW 两种优化器,具备完整训练循环能力。
- BPE 分词与标准化数据流:prepare.py 统一完成数据下载、BPE 分词器训练及数据预处理,提供一致的数据加载与评估接口。
- 与词表无关的评估指标:采用 val_bpb 这一不依赖词汇表大小的指标,使不同架构或分词策略下的实验结果具备横向可比性。
- 代理-环境协同闭环:program.md 扮演 Agent 的“技能说明书”,Agent 按照其中指令读取上下文 → 修改代码 → 启动训练 → 解析指标 → 判断是否采纳 → 进入下一轮迭代。
- 时间归一化执行机制:无论模型规模或 batch size 如何变化,训练始终运行固定时长,消除硬件性能差异对实验公平性的影响。
autoresearch 快速上手指南
-
安装 uv 工具:执行
curl -LsSf https://astral.sh/uv/install.sh | sh获取高效 Python 项目管理器 uv。 -
拉取并同步依赖:进入项目目录后运行
uv sync完成全部依赖安装。 -
准备训练数据:执行
uv run prepare.py下载语料并训练 BPE 分词器(一次性操作,约耗时 2 分钟)。 -
手动验证流程:运行
uv run train.py确保基础训练流程可正常执行(约需 5 分钟)。 - 接入 AI 代理:在本地 IDE 中加载 Claude/Codex 等大模型代理,并将其工作目录指向 program.md。
- 启动自动探索:发送提示如 “Hi have a look at program.md and let’s kick off a new experiment” 触发 Agent 自主迭代。
- 追踪实验进展:次日查阅 train.py 历史版本与日志文件,掌握模型优化路径与最终成果。
autoresearch 的突出价值
- 极致精简架构:仅依赖三个关键文件(prepare.py、train.py、program.md),无第三方服务依赖,单 GPU 即可开箱即用。
- 公平基准体系:5 分钟固定训练时限 + vocab-independent 的 val_bpb 指标,确保各类模型改动均能在同一尺度下衡量成效。
- 人机职责分明:人类通过 program.md 设定研究目标与策略,AI 负责具体编码、训练与判断,形成“人定方向、机做实验”的协作范式。
- 高密度实验吞吐:平均每小时完成约 12 轮实验,整晚可累积近 100 次自动迭代,效率远超人工调试。
- 全程可追溯设计:所有变更集中于 train.py,每次 diff 清晰记录改进逻辑,便于回溯 Agent 的推理路径与优化思路。
autoresearch 的官方资源
autoresearch 与竞品对比分析
| 对比维度 | autoresearch | SciClaw |
|---|---|---|
| **产品定位** | 专注 LLM 训练任务的自主研究代理 | 通用科研场景 AI 同事 / 全生命周期研究协同平台 |
| **核心任务** | 自动改写训练代码、搜索超参、执行训练、评估并筛选有效改进 | 文献检索、实验方案设计、数值模拟、论文撰写、同行评议响应 |
| **研究对象** | nanochat 模型训练(单 GPU 深度学习任务) | 生命科学、化学、物理、材料等多学科交叉科研问题 |
| **实验执行方式** | 直接编辑 Python 脚本并触发本地训练流程 | 任务自动拆解、调用专业工具链、运行仿真计算、对接实验硬件 |
| **评估机制** | 5 分钟限时训练 + val\_bpb 指标自动判定保留/舍弃 | 实验结果解析、学术产出质量评估、科学假说验证闭环 |
| **知识沉淀能力** | 无长期记忆,每次实验基于当前代码与指标独立决策 | 持久化存储项目数据、实验记录、文献库、邮件往来等上下文 |
| **硬件适配要求** | 单张 NVIDIA GPU(如 RTX 4090 / A10) | 支持云端集群调度或本地私有部署,兼容 AI 眼镜与自动化实验台 |
| **交互模式** | 依托 program.md 指令文件 + 大模型代理后台自动运行 | 自然语言对话交互(支持 Web / 飞书 / 钉钉 / Telegram / Discord) |
| **开源状态** | MIT 协议完全开源 | 闭源商业化产品(内测需申请邀请码) |
| **典型用户群体** | AI 研究者、LLM 工程师、算法研究员 | 高校科研人员、博士研究生、企业研发团队 |
| **交付成果形式** | 优化后的模型权重文件 + 完整实验日志 | 学术论文初稿、汇报 PPT、会议海报、审稿回复函、实验总结报告 |
| **自主性层级** | 代码粒度自动演进,聚焦单一训练任务闭环 | 项目级全周期统筹,支持多日异步实验与异常自恢复 |
autoresearch 的典型应用方向
- LLM 超参数空间智能探索:高效遍历学习率、warmup 步数、层数、head 数等组合,快速锁定高性能配置。
- 新型模块实效验证平台:低成本验证 Rotary Embedding、FlashAttention、SwiGLU 等前沿组件的实际增益。
- 边缘端小模型性能调优:在消费级显卡上自动提升 nano-scale 模型的语言建模能力,助力个人开发者与初创团队。
- AI 科学家可行性研究沙盒:作为概念验证系统,用于探讨人工智能是否具备定义问题、设计实验、归纳结论的完整科研能力边界。


