





Nginx后端故障自动平滑切换需协同proxy_next_upstream、健康检查、重试边界与错误类型控制;默认仅重试error/timeout,502/503/504需显式配置,500/404/403慎用;tries≤节点数、timeout≥read_timeout;需至少2台主节点并配max_fails/fail_timeout实现被动健康检查;非幂等请求如POST默认不重试。
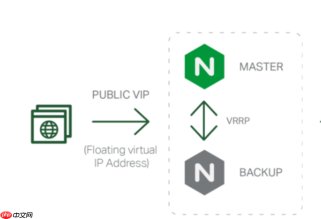
要让 Nginx 在后端节点故障时自动平滑切换,核心不是只开一个开关,而是把 proxy_next_upstream 和上游健康感知、重试边界、错误类型精准控制这三块协同起来。单独配置任一环节,都容易出现“配了但不切换”“切了但更慢”或“重复提交”的问题。
明确哪些失败才允许重试
默认情况下,Nginx 只对 error(连接拒绝、断连、DNS 失败)和 timeout(建连/发请求/读响应头超时)触发重试,不会自动重试 502、503、504 这类 HTTP 错误码——必须显式写出来:
-
必加:
error timeout—— 覆盖底层网络异常和响应卡死场景 -
推荐加:
http_502 http_503 http_504—— 这三类多是后端瞬时过载、进程崩溃或网关超时,重试大概率成功 -
慎加或不加:
http_500 http_404 http_403—— 前者可能是业务逻辑错误,后者多为路径缺失,重试无意义甚至引发重复下单、计费等风险 -
建议加:
invalid_header—— 防止后端返回空响应或非法头(如缺 Status 行),这类失败常被忽略但真实存在
限制重试行为,避免雪崩或长延迟
重试不是越多越好,必须用两个参数框定安全边界:

aperture: the L402 aware reverse proxy
下载
安装并运行 Aperture(Lightning Labs 的 L402 闪电反向代理),用于创建 L402 付费墙、配置付费 API 端点、为其他代理托管付费内容或测试 L402 认证流程。
-
proxy_next_upstream_tries 3:最多尝试 3 个不同节点(含首次),设为 3 比较稳妥;若 upstream 只有 2 台主节点,该值不宜超过 2,否则最后一次会落空 -
proxy_next_upstream_timeout 10s:从第一次请求发出开始计时,总耗时超 10 秒就终止并返回错误;它应 ≥ 单次proxy_read_timeout(比如设为 5s),但不能过大——否则 4 台后端各卡 8 秒,用户可能等满 32 秒才失败
配合被动健康检查,让“失败”真正变成“规避”
proxy_next_upstream 是“失败后兜底”,不是“提前绕开”。若不配健康检查,Nginx 仍会轮询到已宕机但尚未标记的节点,导致每次请求都先失败再重试,白白消耗资源:
- 在
upstream块中为每个节点加max_fails=3 fail_timeout=30s:连续 3 次由proxy_next_upstream触发的失败(error/timeout/502 等)后,该节点会被剔除 30 秒,期间不参与任何调度 - 可选加
backup节点:仅当所有主节点都被标记为不可用时才启用,作为最后一道防线,适合部署灾备实例或降级服务 - 注意:只有 upstream 中定义了 ≥2 台主节点,
proxy_next_upstream才有“下一个”可切;单节点配置无效
区分请求方法,防止非幂等操作被误重试
Nginx 默认只对 GET 和 HEAD 请求重试,这是安全设计:
-
POST、PUT、DELETE等非幂等方法,即使你写了http_502,也不会自动重试——除非后端确认完全幂等(例如基于唯一请求 ID 做了去重),否则不要强行开启 - 若业务强依赖 POST 重试,应在应用层实现重试+去重,而不是靠 Nginx 层面绕过语义约束


