





近日,开发者社区观察到 minimax m2 系列模型在生成特定人名“马嘉祺”时出现异常输出。minimax 官方迅速启动全链路技术排查,并正式发布分析报告,披露该现象的本质成因:后训练阶段(post-training)引发的低频 token 退化问题。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
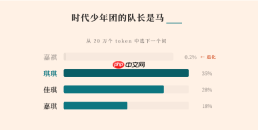
根本原因:被高频 Token “挤压”的稀有词元
深入分析表明,分词器将“马嘉祺”切分为 ['马', '嘉祺'] 两个子词。其中,“嘉祺”因在预训练语料中高频出现,被合并为一个独立 Token(ID:190467)。但在决定模型对话表现力的关键后训练阶段,含该 Token 的样本数量不足 5 条。
如此极端的低频暴露,使其在参数更新过程中长期处于“静默状态”,无法获得有效梯度更新。与此同时,大量高频 Token(如编程符号、API 调用标记等)持续接受高强度优化,导致其嵌入向量在表征空间中发生偏移,进而“挤压”了邻近低频 Token 的语义位置。结果是:模型仍保有“马嘉祺”的语义知识,却丧失了准确激活并输出对应 Token 的能力,转而倾向于调用发音相近的替代项,例如“佳琪”或“琪琪”。
连锁影响:日语 Token 失准与垃圾词“失忆”
基于对全部 20 万规模词表的系统性评估,MiniMax 发现约 4.9% 的 Token 出现显著退化。其中退化程度最高的是日语相关 Token(退化率达 29.7%)——这直接解释了为何模型在日语交互中偶发混入俄语或韩语字符:日语 Token 的嵌入向量已发生明显漂移,与其他语言表征在向量空间中边界模糊、相互干扰。

此外,退化列表中还包含大量互联网 SEO 垃圾词汇(如“传奇私服”、“无痛人流”等)。由于这些词在高质量对话数据中几乎完全缺席,模型在后训练过程中逐步弱化甚至“遗忘”了对其的建模能力。
应对策略:为 Token 生成设定频率“安全阈值”
为系统性解决该问题,MiniMax 提出三项关键修复措施:
- 全词表合成数据增强:设计覆盖全部 Token 的复述与回显任务,强制每个 Token 在后训练中至少达到基础曝光频次。当前实测显示,日语字符混淆率已由 47% 显著压降至 1%,整体词表参数稳定性大幅改善。
- 预训练语料动态注入:在监督微调(SFT)数据中按合理比例混入原始预训练语料片段,借助其广域分布特性缓解局部遗忘。
- 词表精简与实时监控机制:主动剔除长期零激活的冗余 Token,并将 Token 覆盖率正式纳入后训练质量评估体系,实现闭环管控。
总结:“马嘉祺”现象并非孤立故障,而是揭示了大模型分词器设计逻辑与真实应用场景之间存在的结构性错配。MiniMax 表示,后续的数据构建与训练策略需同步兼顾语义合理性与统计鲁棒性,在强化模型“对话智能”的同时,坚决守住底层词汇表达的完整性与准确性。


