





inworld ai 最近发布了其全新一代语音合成模型 —— 实时 tts-2。该模型现已面向开发者开放研究预览,可通过 inworld api 与 inworld realtime api 进行调用,目标是重新定义语音 ai 在实时交互场景中的表现力。不同于传统语音合成技术仅将静态文本转化为音频,tts-2 具备实时音频感知能力,可动态捕捉用户语速、停顿、重音及情绪起伏,从而实现更具临场感与人性化的双向对话。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
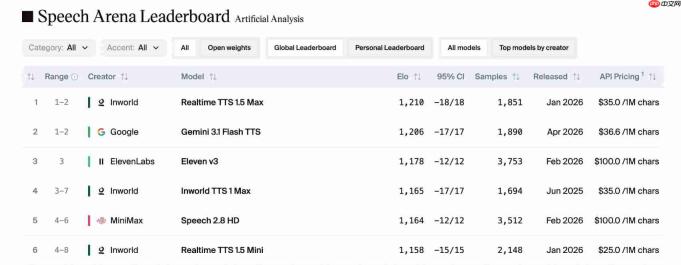
TTS-2 的核心突破在于其“闭环音频处理”架构。它跳过了依赖 ASR(自动语音识别)转录文本这一中间环节,直接以原始音频流作为输入。这种设计让模型能精准分辨同一句台词在不同语境下的深层含义。例如,“行吧,不说了”在疲惫低沉的声线中暗示放弃,而在轻快上扬的语调里可能只是调侃——TTS-2 正是通过捕捉这些声学细节,显著增强了回应的情感适配度与对话自然度。

AI 舌诊面诊问诊医疗系统 + 诊疗商城系统源码是一套结合 AI 辅助诊断与商品转化的健康类程序,基于浩创云、ThinkPHP(PHP)开发,支持微信服务号与 H5 端,适合做中医舌诊面诊问答、健康建议推送以及配套诊疗商品的运营。
该模型集成了四项关键能力,构建起差异化优势:
✅ 语音指令控制:开发者可在推理过程中使用自然语言提示(如“稍微带点犹豫”“加快语速但保持友好”)灵活调控语音表达,摆脱僵化的情感标签体系;
✅ 上下文感知能力:依托闭环结构,模型持续追踪对话历史与语音特征,使回应更贴合当前交流节奏与关系进展;
✅ 跨语言语音一致性:支持超百种语言的识别与合成,且在同一角色声音下实现多语种无缝切换,语音特质(音色、语感、个性)全程统一;
✅ 文本驱动的声音定制:开发者仅需输入描述性文字(如“一位温和的中年女性,略带南方口音,语速适中,常带微笑感”),即可生成可复用、风格稳定的角色音色,无需提供任何参考语音样本。
TTS-2 的发布,标志着 Inworld AI 在语音交互领域迈入新阶段——不再止步于“说得像”,而是追求“听得懂、接得准、应得真”。它在保障高保真音频输出的同时,深度强化了语境理解力与声音人格的一致性,为游戏 NPC、虚拟助手、教育陪练等场景带来更具沉浸感的体验升级。Inworld AI 希望借此在日益白热化的智能语音赛道中,树立下一代对话式 AI 的新标杆。
划重点: ? ** 实时对话感知 **: TTS-2 以音频直连闭环架构,实时解析用户语气、节奏与情绪状态; ? ** 全球化语音身份 **: 单一声音模型覆盖 100+ 语言,支持对话中任意切换,音色与个性始终如一; ?️ ** 文本即音色 **: 仅凭文字描述即可生成可复用、风格可控的角色语音,彻底摆脱音频采样依赖。






