





FlashQLA是什么
flashqla 是通义实验室开源的基于 tilelang 实现的高性能线性注意力算子库。flashqla 通过算子融合、gate 驱动卡内序列并行及 warp-specialized 优化,在 hopper 上较 fla triton 实现 2–3× 前向与 2× 反向加速,覆盖 2b 至 397b 模型,提升预训练与端侧推理效率。flashqla 需 sm90、cuda 12.8+、pytorch 2.8+ 环境。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
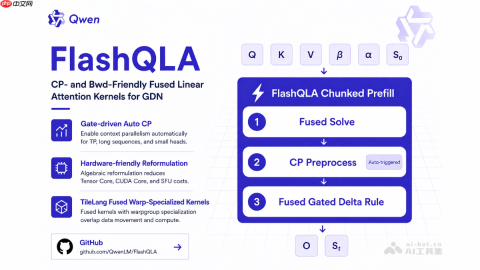

FlashQLA的主要功能
- 高性能线性注意力算子库:面向 Qwen 全系列 Gated Delta Network(GDN)注意力层进行深度优化。
- 算子融合加速:将 GDN Chunked Prefill 的前向与反向流程进行合理的算子融合与性能优化。
- 全规格模型覆盖:支持从 2B 到 397B 的多规格模型,覆盖 TP1 至 TP8 场景。
- 双层级 API 接口:提供对齐 FLA 签名的 high-level API,以及底层 fwd / bwd 入口。
- 变长序列支持:内置 varlen 变长序列处理能力,适配真实训练与推理数据分布。
FlashQLA的技术原理
- TileLang Warp-Specialized Kernel:基于 TileLang 构建关键 fused kernel,采用 warpgroup specialization 实现数据搬运、Tensor Core 计算与 CUDA Core 计算的重叠。
- 自动化卡内序列并行(AutoCP):利用 GDN gate 的指数衰减性质,在 TP、长序列、小头数等场景下自动开启卡内序列并行,提高 GPU SM 利用率。
- 滑动窗口 warmup 机制:针对具备衰减性质的线性注意力头,仅用 6–8 个 chunk 的 warmup 即可精确获得子序列初始状态,舍弃修正量 M 矩阵的计算。
- 硬件友好的代数改写:对 GDN Chunked Prefill 的前向和反向流程进行代数变换,在不影响数值精度的前提下有效降低 Tensor Core、CUDA Core 及 SFU 开销。
- 兼顾访存与并行的折中架构:将计算流程拆分为两个 fused kernel 并在中间插入 CP 预处理,避免 fully-fused kernel 在小 batch / TP 场景下 GPU 利用率低的问题。
如何使用FlashQLA
- 环境检查:确认硬件为 NVIDIA SM90(Hopper 架构)且软件环境满足 CUDA 12.8+、PyTorch 2.8+ 的要求。
- 安装部署:从 GitHub 克隆 FlashQLA 仓库并通过 pip 完成编译安装。
- 模块导入:在 Python 中导入 chunk_gated_delta_rule 函数。
- 数据准备:准备好输入张量 q、k、v 以及 gate 参数 g、beta,确保各张量形状符合接口要求。
- 执行计算:调用 chunk_gated_delta_rule 并传入对应参数,获取输出结果 O 和最终状态。
- 高级配置:如需处理变长序列,可传入 cu_seqlens 参数;如需状态续传,可传入 initial_state。
- 自动优化:AutoCP 序列并行会根据 batch 大小和序列长度自动触发,无需手动配置。
FlashQLA的关键信息和使用要求
- 发布方:通义实验室 / QwenTeam
- 开源地址:github.com/QwenLM/FlashQLA
- 硬件要求:NVIDIA SM90(Hopper 架构,如 H200)
- 软件要求:CUDA 12.8+,PyTorch 2.8+
- 支持模型:Qwen3.5 / Qwen3.6 系列(head dim 覆盖 64 至 8,对应 TP1 至 TP8)
- 加速效果:前向 2–3×,反向 2×(相较 FLA Triton Kernel)
FlashQLA的核心优势
- 兼顾访存与并行的折中架构:将计算拆分为两个 fused kernel 在中间插入 CP 预处理,避免 fully-fused kernel 在小 batch / TP 场景下 GPU 利用率低的问题,通过合理拆分减少 HBM 反复读写中间变量的访存开销。
- AutoCP 自动开启机制:仅在 batch_size × num_heads ≤ 40 或 batch_size × num_heads ≤ 56 且 seq_len ≥ 8192 时自动触发卡内序列并行,避免不必要的冗余计算,自适应平衡并行度与访存代价。
- 滑动窗口 warmup 机制:用 GDN gate 的指数衰减性质,对 60–80% 的线性注意力头仅需 6–8 个 chunk 的 warmup 可精确获得子序列初始状态,直接舍弃修正量 M 矩阵的计算,大幅降低 CP 预处理开销。
- Warp-Specialized 计算重叠:基于 TileLang 的 warpgroup specialization 设计,在同一个 SM 内实现生产者与消费者 warpgroup 协同,通过 ping-pong 结构遮盖数据搬运与 Tensor Core / CUDA Core 计算。
- 硬件友好的代数改写:对前向和反向流程进行代数变换与化简,在不影响数值精度的前提下有效降低 Tensor Core、CUDA Core 及 SFU 的硬件开销。
FlashQLA的项目地址
- 项目官网:http://qwen.ai/blog?id=flashqla
- GitHub仓库:http://github.com/QwenLM/FlashQLA
FlashQLA的同类竞品对比
| 对比维度 | FlashQLA | FLA (Flash Linear Attention) | FlashInfer |
|---|---|---|---|
| 定位 | Qwen GDN 专用高性能算子库 | 通用线性注意力算法库 | 通用 LLM 推理优化引擎 |
| 技术路线 | TileLang Warp-Specialized Kernel | Triton Kernel 分步实现 | CUDA Kernel 预编译优化 |
| 前向加速 | 基准 | 2.95× slower | 5.33× slower (397B TP8 32K) |
| 反向加速 | 基准 | 2× slower | 不支持 / 未优化 |
| 序列并行 | 自动卡内 CP (AutoCP) | 手动配置 CP | 不支持 GDN 专用 CP |
| 算子融合度 | 双 fused kernel + CP 预处理 | 每步独立 kernel | 通用 fused attention |
| 滑动窗口优化 | Gate warmup 机制,免 M 矩阵 | 标准 CP 需计算 M 矩阵 | 无 |
| GPU 利用率 | 自动提升小 batch / TP 场景 SM 利用率 | 小头数场景利用率受限 | 通用场景优化 |
| 硬件要求 | SM90 (Hopper), CUDA 12.8+ | 通用 NVIDIA GPU | 通用 NVIDIA GPU |
| 模型适配 | Qwen3.5 / Qwen3.6 全系列 | 通用线性注意力模型 | 通用 LLM 推理 |
| 开源状态 | 开源 (GitHub) | 开源 | 开源 |
FlashQLA的应用场景
- 超大模型预训练:覆盖 397B / 122B / 35B / 27B 等全系列 Qwen 模型,支持 256K 长上下文训练,显著降低注意力层在端到端训练中的算力与时间开销
- 端侧 agentic 推理:针对 batch_size=1、小尺寸模型(如 2B / 0.8B)的 chunked prefill 场景,通过 AutoCP 提升小头数下的 GPU 利用率,加速端侧 Agent 实时响应
- 大模型线上部署:在 TP(Tensor Parallelism)场景下处理 coding agent 等长序列输入,解决 chunked prefill 开不出足够大 batch 时的 GPU 利用率瓶颈,提升服务吞吐
- 通用 GDN / 线性注意力架构加速:适用任何基于 Gated Delta Network 或线性注意力架构的 LLM 训练与推理,提供开箱即用的高性能算子替换方案



