





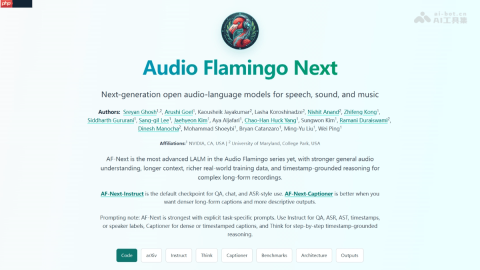
audio flamingo next 是 nvidia 与马里兰大学联合推出的全新一代开源大型音频语言模型(lalm),作为 audio flamingo 系列的进阶版本,专为深度理解语音、环境声与音乐而构建。该模型原生支持最长 30 分钟的复杂音频输入,上下文长度高达 128k token,依托超大规模训练数据(约 1.08 亿样本、100 万小时音频)及创新技术架构,在多项权威音频理解基准中刷新开源模型性能纪录。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

gemini-image-generation
下载
使用 Google GenAI SDK 通过 Gemini 生成或编辑图像。当用户要求在 OpenCla… 中创建、转换、渲染或保存一张或多张图像时使用。
Audio Flamingo Next 的核心能力
- 超长音频建模:可端到端处理持续达 30 分钟的混合音频流,无缝融合语音对话、背景环境音与多段落音乐,实现跨时间尺度的语义统一理解。
- 时间感知推理:首创 Temporal Audio Chain-of-Thought(时间音频思维链)范式,结合 Rotary Time Embeddings(RoTE)位置编码,使模型推理过程显式绑定音频时间轴,精准聚合分散于长时段中的关键信息。
- 全任务统一架构:单模型覆盖语音识别(ASR)、音乐结构解析、声景分类、音源定位等多类任务,无需切换专用子模型,显著降低部署复杂度。
- 多说话人精细化建模:支持说话人身份识别、轮次划分与语义归属,在会议录音、播客访谈等真实场景中准确还原对话逻辑与角色关系。
- 高精度时序检索:具备“毫秒级定位”能力,可在数十分钟音频中快速锁定指定关键词、事件片段或某位说话人的特定发言,响应细粒度时间点提问。
- 场景化模型变体:提供 AF-Next-Instruct(通用问答与指令执行)、AF-Next-Think(分步时间推理与因果分析)、AF-Next-Captioner(密集型音频内容描述)三大轻量优化版本,按需选用。
如何上手 Audio Flamingo Next
- 获取模型:全部权重已开放下载,可通过 Hugging Face 官方页面(huggingface.co/nvidia/audio-flamingo-next-hf)获取 Instruct / Think / Captioner 三个变体,适用于非商业研究用途。
- 云端体验:官方提供预配置 Colab Notebook 与 Gradio 演示应用,无需本地环境即可实时交互体验音频理解能力。
- 本地部署:GitHub 仓库含完整训练/推理代码、依赖说明与 API 接口文档,支持 Python 脚本调用、命令行交互及 RESTful 服务封装。
- 选型建议:日常问答与语音转写推荐 Instruct;需时间序列分析(如“第12分37秒发生了什么?”)选用 Think;生成详尽音频报告或教学注释则优先 Captioner。
- 输入规范:兼容 WAV、MP3、FLAC 等主流格式,建议采样率 16kHz,单文件时长≤30分钟;更长音频可自动分块处理并保持上下文连贯性。
- 运行条件:本地推理建议配备显存≥16GB 的 GPU;Colab 免费版已适配 T4 GPU,开箱即用。
Audio Flamingo Next 的底层技术机制
- 时间锚定推理框架:以 RoTE 替代传统 RoPE,将时间戳作为核心位置信号嵌入每一层注意力计算,配合 Temporal Audio Chain-of-Thought 训练策略,使中间推理步骤可追溯、可验证、可解释。
- 四阶段渐进训练流程:① 音频编码器与语言模型适配对齐;② 扩展至 10–30 分钟长音频微调;③ 基于 GRPO 的强化学习后训练,提升安全性与指令遵循鲁棒性;④ 时间锚定 CoT 微调,强化时序逻辑建模能力。
Audio Flamingo Next 的关键参数与约束
- 研发主体:NVIDIA 与马里兰大学联合团队
- 开源程度:模型权重、训练代码、数据处理脚本、评估工具链全部开源(研究许可)
- 模型规模:基于 Qwen-2.5-7B 构建,总参数量约为 7B(部分资料亦标注为 8B,系量化前原始参数量)
- 硬件需求:GPU 加速为必需,支持 128K token 长上下文处理
- 音频规格:最高支持 30 分钟、16kHz 单声道音频输入
- 使用许可:仅限非商业研究用途,商用需另行授权
Audio Flamingo Next 的突出优势
- 长音频理解领先:LongAudioBench 综合得分达 73.9,大幅超越 Gemini 2.5 Pro(60.4);
- 多模态一体化设计:语音、音乐、环境声三类音频在统一架构下联合建模,消除任务割裂;
- 时间可解释性强:所有输出均可回溯至具体时间区间,支撑教育、司法、医疗等高可信度场景;
- 语音识别精度突破:LibriSpeech test-clean 集词错率(WER)低至 1.54%,创当前 LALM 类别最优水平。
Audio Flamingo Next 的官方资源入口
- 项目主页:https://www.php.cn/link/cabe93e7ad2813b2009aae33c3974878
- GitHub 仓库:https://www.php.cn/link/47f6859a4b65704f72f72f15c0db9421
- Hugging Face 模型页:https://www.php.cn/link/e4eb1d8f1a1832a196b459c41b2f7c80
- 技术论文(arXiv):https://www.php.cn/link/611a80e9562b4c0738021647c910846f
Audio Flamingo Next 的横向对比分析
| 维度 | Audio Flamingo Next | Qwen2.5-Omni | Gemini 2.5 Pro |
|---|---|---|---|
| **开发方** | NVIDIA/马里兰大学 | 阿里云 | |
| **开源性** | 全开源(权重+代码+数据) | 开源权重 | 闭源API |
| **音频时长** | 30分钟 | 较长音频 | 长音频 |
| **MMAU平均** | 75.76(Captioner) | 未公开 | 未公开 |
| **MMAU-Pro** | 58.7(Think) | 未公开 | 57.4 |
| **LongAudioBench** | 73.9 | 未公开 | 60.4 |
| **LibriSpeech WER** | 1.54 | 竞争水平 | 未公开 |
| **特色能力** | 时间锚定思维链 | 全模态端到端 | 通用长上下文 |
| **参数规模** | 7B | 未知 | 未知 |
| **许可限制** | 研究用途 | 商业友好 | 商业API |
Audio Flamingo Next 的典型应用场景
- 播客与知识音频深加工:自动提炼 30 分钟以内播客的核心论点、人物观点与逻辑脉络,支持按主题/时间/发言人多维检索与问答。
- 智能会议助手:实时转录多方会议语音,识别说话人身份与发言顺序,生成带时间节点的纪要、待办事项与责任分配清单。
- 音乐教学与创作辅助:识别乐器组合、节拍变化、调性转换,回答乐理问题(如“副歌部分使用了哪种和弦进行?”),辅助作曲与编曲分析。
- 影视与游戏音频工程:为视频片段自动生成专业级音频描述(含情绪、节奏、音色、空间感等维度),辅助音效库检索、AI 配乐匹配与无障碍字幕生成。











