





Nginx开源版不支持主动健康检查,仅提供基于max_fails和fail_timeout的被动检查;需通过nginx_upstream_check_module第三方模块或升级Nginx Plus实现主动探测。
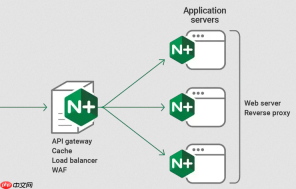
Nginx 本身在开源版本中 不内置主动健康检查(active health check)功能,upstream 模块默认只支持被动健康检查(如 fail_timeout、max_fails),即靠请求失败后标记服务器为不可用。要实现真正的主动探测(如定期发 HTTP 请求检测后端是否存活),需借助第三方模块或升级到商业版。
开源 Nginx 的被动健康检查机制
这是最基础、无需额外模块的方式,依赖实际请求的反馈来动态调整后端状态:
- max_fails:连续失败多少次后,将该 server 标记为不可用
- fail_timeout:标记为不可用的时间窗口(单位秒),超时后会尝试恢复连接
- backup:仅当其他非 backup 节点全部失效时才启用,常用于容灾
示例配置:
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s backup;
}
注意:这种机制无法提前发现“已启动但服务未就绪”或“接口卡死无响应”的情况,存在误判延迟。
使用 nginx_upstream_check_module(推荐开源方案)
这是一个广泛使用的第三方模块,支持 TCP/HTTP 主动健康检查,兼容主流 Nginx 版本(需编译时添加):

- 支持周期性发送 HEAD 或 GET 请求,校验返回状态码、响应头或响应体内容
- 提供 /status 接口实时查看各节点健康状态(需配合 stub_status)
- 需从源码编译安装,不能通过 apt/yum 直接获取
启用后典型配置如下:
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    check interval=3 rise=2 fall=5 timeout=1 type=http;
    check_http_send "HEAD /health HTTP/1.0\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
}
说明:rise=2 表示连续 2 次成功则恢复上线;fall=5 表示连续 5 次失败才下线;type=http 启用 HTTP 检测模式。
使用 Nginx Plus(官方商业版)
Nginx Plus 原生支持高级健康检查,配置简洁且功能完整:
- 支持
health_check指令,可指定间隔、失败阈值、匹配规则(如 status、header、body) - 集成实时 dashboard 和 API,便于运维观测与自动化联动
- 支持 TLS 健康检查、自定义请求头、JWT 鉴权等企业级能力
示例:
upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
}

server {
    location /backend {
        proxy_pass http://backend;
        health_check interval=5 fails=3 passes=2 uri=/health match=welcome;
    }
}

match welcome {
    status 200;
    header Content-Type = "text/plain";
    body ~ "OK";
}
补充建议与注意事项
- 后端务必提供轻量、可靠的健康检查端点(如
/health),避免触发业务逻辑或数据库查询 - 检查路径不应被限流、鉴权或日志大量刷写,否则可能干扰判断或造成性能压力
- 主动检查频率不宜过高(一般 3–10 秒),避免给后端带来额外负担
- 结合日志和监控(如 Prometheus + nginx-vts-exporter)可更全面掌握 upstream 状态变化





