





max_fails是在fail_timeout时间窗口内连续失败指定次数后,将上游服务器临时标记为不可用的阈值,超时后自动恢复探测,并非永久剔除或成功率熔断。
max_fails 是什么,不是“失败次数上限”
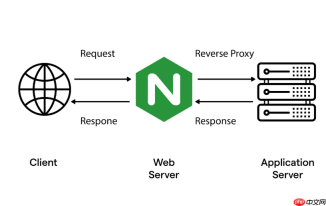
max_fails 并不表示“最多允许失败 N 次就永久踢出”,它只控制在 fail_timeout 时间窗口内连续失败多少次后,Nginx 会将该 upstream server 标记为“不可用”,进入临时摘除状态。这个状态持续 fail_timeout 秒,之后自动尝试恢复连接。
常见误解是把它当成功率熔断阈值——比如设成 max_fails=1 就以为“一挂就下线”,但实际是否触发取决于失败是否“连续”、是否落在同一个 fail_timeout 周期内。
- 失败必须是 Nginx 主动探测到的:超时(
timeout)、连接拒绝(connection refused)、502/503/504 等网关类响应(需配合proxy_next_upstream) - HTTP 200 + body 报错(如业务返回 {“code”:500})不会触发
max_fails计数 - 默认值是
max_fails=1,fail_timeout=10s,但生产环境几乎总是需要调大
如何设定 max_fails 和 fail_timeout 的组合值
关键不是孤立看 max_fails,而是和 fail_timeout 构成一个“健康观察窗口”。典型场景下建议按服务恢复能力反推:
- 后端是 Kubernetes Pod,滚动更新时可能短暂 502:设
max_fails=3+fail_timeout=30s,避免单次抖动误判 - 后端有慢启动(如 Java 应用冷加载耗时 8–12s):至少设
fail_timeout=20s,max_fails=2,否则第一个 probe 就失败,第二个立刻再失败,直接摘除 - 后端依赖外部 DB 或缓存,偶发 503:启用
proxy_next_upstream error timeout http_503,再配max_fails=3/fail_timeout=60s - 不要设
max_fails=0:Nginx 会禁用失败计数逻辑,等于放弃主动健康检查
示例配置片段:

upstream backend {
    server 10.0.1.10:8080 max_fails=3 fail_timeout=30s;
    server 10.0.1.11:8080 max_fails=3 fail_timeout=30s;
    keepalive 32;
}
max_fails 不生效?检查 proxy_next_upstream 和状态码范围
max_fails 是否触发,强依赖 proxy_next_upstream 的配置。默认它只重试 error(连接中断)和 timeout,**不包含任何 HTTP 状态码**。
- 如果后端返回 502 但没配
http_502,Nginx 不认为这是“失败”,不会累加max_fails - 常见漏配:
proxy_next_upstream error timeout http_500 http_502 http_503 http_504 - 注意:
http_404或http_401不应加入——它们是业务正常响应,加入会导致合法请求反复重试 - 若用
health_check(Nginx Plus)或第三方模块(如 nginx_upstream_check_module),逻辑独立于max_fails,别混用
自动容灾不是万能的:max_fails 无法覆盖的盲区
靠 max_fails 实现的被动摘除,本质是“反应式”机制,存在明显延迟和边界限制:
- 首次失败到摘除至少要等满
max_fails次失败 —— 如果max_fails=3且每 5 秒一次请求,最快也要 10 秒以上才摘除 - 没有主动探活:server 进程僵死但端口仍通(TCP SYN-ACK 正常),Nginx 无法识别,
max_fails完全不触发 - 流量打到已摘除节点后,不会“回填”给其他节点:Nginx 仅跳过该 server,但当前请求可能已超时或返回错误,不保证重试成功
- 多级 upstream(如嵌套 split_clients 或 geo)中,
max_fails只作用于最内层 server,上层无感知
真正稳定的容灾需要组合手段:主动健康检查(如 check 模块或自建 /health 端点轮询)+ 限流降级(limit_req)+ 后端可观测性(指标驱动的扩缩容),max_fails 只是其中一层兜底。


