longcat-next是什么
longcat-next是由美团longcat团队研发的多模态大语言模型,其核心突破在于原创的loza稀疏注意力机制。该机制通过动态评估各模块的重要性,将约50%低贡献度模块替换为流式稀疏注意力计算单元,构建出全局与局部交替覆盖的zigzag注意力结构。模型实测支持100万token超长上下文,推理速度提升达10倍,算力开销降低30%,硬件资源利用率提升至原有两倍。目前提供两个版本:面向1m上下文实验场景的flash-exp,以及基于68.5b moe架构、更轻量高效的flash-lite,在多项长文本任务中性能超越qwen-3。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
LongCat-Next的主要功能
- 百万级上下文解析能力:原生支持100万Token长文本建模,相同硬件条件下可处理长度翻倍的文档内容,显著缓解上下文截断难题。
- LoZA稀疏注意力架构:依托模块重要性识别策略,融合流式稀疏计算与ZigZag交错布局,兼顾全局语义连贯性与局部细节捕捉能力。
- 高性能推理优化:在128K上下文场景下解码效率提升10倍;256K预加载阶段提速50%,大幅压缩端到端响应延迟。
- 低功耗部署方案:256K长度下的解码过程算力消耗减少30%,助力企业以更经济的硬件投入落地高质量大模型服务。
- 双轨产品形态适配:涵盖支持1M上下文的实验版Flash-Exp与参数量为68.5B的MoE轻量版Flash-Lite,灵活匹配科研探索与工业落地需求。
- 强鲁棒性长文本表现:在MRCR长文本评测基准中全面优于Qwen-3,在复杂文档问答、跨文件代码生成等高难度任务中保持更高稳定性与准确性。
LongCat-Next的关键信息和使用要求
- 研发主体:美团龙猫团队(Meituan LongCat)
- 核心技术:LoZA(LongCat ZigZag Attention)稀疏注意力机制
- 上下文容量:最高支持1,000,000 Token(即1M)
- 模型结构:68.5B MoE架构,单次前向推理激活参数量为2.9B–4.5B
- 性能指标:128K解码提速10×、256K预加载加速50%、整体算力节省30%
- 硬件兼容性:未公开最低配置要求,但LoZA设计显著降低对高端GPU集群的依赖
- API服务能力:Flash-Lite版本已开放API接入,实测生成吞吐达500–700 token/s
LongCat-Next的核心优势
- 突破性上下文扩展能力:支持1M Token超长文本建模,在不升级硬件的前提下实现两倍于常规模型的文档处理长度,彻底打破长文本理解瓶颈。
- 智能稀疏注意力调度:LoZA机制依据模块语义权重自动裁剪冗余计算路径,用50%稀疏化模块构建ZigZag结构,在保障精度的同时大幅提升计算效率。
- 极致推理响应速度:128K长度下解码速率提升10倍,256K预加载耗时缩减一半,有效缩短用户等待时间与系统资源占用周期。
- 低成本规模化部署:256K解码阶段能耗下降30%,同等性能下硬件投入减少,为企业级AI应用降本增效提供坚实支撑。
- 持续稳定的任务表现:在MRCR长文本权威测试集中领先Qwen-3;常规问答与代码生成任务与基线持平,面对复杂逻辑或多跳推理场景更具可靠性。
如何使用LongCat-Next
- 开源模型获取:前往GitHub官方仓库下载已发布的模型权重、训练脚本及推理工具链,支持本地快速部署与二次开发。
- 硬件适配建议:得益于LoZA稀疏注意力机制,可在主流消费级或数据中心级显卡上运行长文本任务,无需强制升级至旗舰级设备。
LongCat-Next的项目地址
- 项目官网:https://www.php.cn/link/259906fe75ccb82413807004cf730c03
- GitHub仓库:https://www.php.cn/link/9f1d02b2b8503d48b09f6a13dfa62af3
- HuggingFace模型库:https://www.php.cn/link/2238a29937e4148109bacb299229e5bd
- 技术白皮书:https://www.php.cn/link/9f1d02b2b8503d48b09f6a13dfa62af3/blob/main/tech\_report.pdf
LongCat-Next的同类竞品对比
| 对比维度 | LongCat-Next | Qwen-3 | GPT-4 |
|---|---|---|---|
| **长文本评测表现** | MRCR基准**领先**Qwen-3 | 此前表现优异者 | 未披露MRCR相关结果 |
| **最大上下文长度** | **1,000,000 Token** | 未明确达到同量级 | 约128,000 Token |
| **底层注意力机制** | **LoZA稀疏注意力** | 标准全连接注意力 | 技术细节未公开 |
| **推理效率** | 128K解码**快10倍** | 暂无公开量化对比 | 依赖高算力基础设施 |
| **算力成本控制** | **降低30%**,硬件利用率提升100% | 符合行业常规水平 | API调用成本较高 |
LongCat-Next的应用场景
超长文档智能分析:适用于法律合同、科研论文、工程手册等百万字级文本的深度阅读、关键信息抽取、跨段落摘要生成与精准检索,彻底规避传统模型因上下文限制导致的信息丢失问题。
全量代码库协同开发:可一次性建模百万行级开源或私有项目,完成跨模块依赖分析、函数级重构建议、长上下文补全及多文件协同编码,赋能新一代AI原生开发体验。
企业级知识中枢构建:依托内部海量非结构化文档(如制度规范、会议纪要、客户案例),打造低延迟、高准确率的知识问答与辅助决策系统,兼顾性能与部署成本。
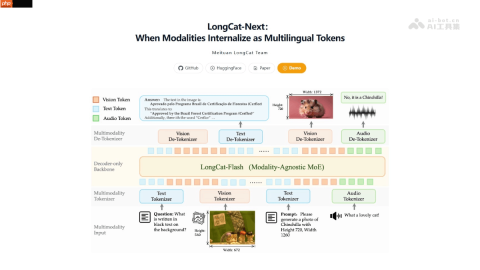
跨模态长序列理解演进:后续将拓展至长视频分镜解析、图文混合长文档理解等方向,实现图像、文本、语音等多源异构信息在超长时序维度上的统一建模与联合生成。