





近日,cnmo关注到,苹果公司的科研人员研发出一种全新的图像描述生成ai模型训练策略,该方法不仅能够产出更为精确、详尽的图像描述,而且所构建的模型体积显著小于当前主流同类方案。
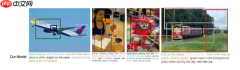
在题为《RubiCap:Rubric-Guided强化学习用于密集图像描述生成》的最新论文中,苹果研究院联合威斯康星大学麦迪逊分校共同提出了一套面向密集图像描述任务的建模新范式,并在多项权威基准测试中刷新了性能纪录。所谓“密集图像描述”,是指对图像中各个局部区域及关键元素分别生成精细化语义描述,而非仅输出一段笼统的整体概括。这种能力有助于深化对图像内容的理解,在视觉语言模型预训练、文本到图像生成、智能图像检索以及无障碍辅助技术等领域具有重要应用价值。
研究团队指出,当前主流的密集描述模型训练方式存在明显瓶颈:一方面,依赖人工标注高质量细粒度描述数据成本极高、效率低下;另一方面,虽可借助大视觉语言模型(VLM)自动生成合成描述以缓解数据稀缺问题,但通过监督蒸馏方式训练所得模型往往缺乏表达多样性,泛化能力受限;而传统强化学习虽具备提升多样性和鲁棒性的潜力,却难以适配开放式、无固定模板的自然语言描述生成任务。

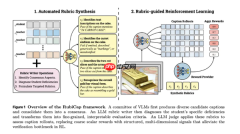
针对上述挑战,团队设计了RubiCap框架。他们从PixMoCap与DenseFusion-4V-100K两大公开数据集中随机采样5万张图像,调用Gemini 2.5 Pro、GPT-5等先进视觉语言模型为每幅图像批量生成多个候选描述;与此同时,待优化的RubiCap模型也同步输出其自身的描述结果。随后,Gemini 2.5 Pro负责综合分析原始图像、候选描述集合及模型输出,动态构建评估维度与评判准则;最终由Qwen2.5-7B-Instruct依据该准则对各描述进行打分,形成可用于策略优化的稀疏奖励信号。
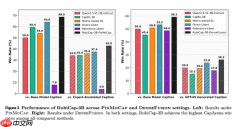
基于该训练流程,团队成功推出了RubiCap-2B、RubiCap-3B和RubiCap-7B三款不同规模的模型,参数量分别为20亿、30亿和70亿。实验结果显示,这些模型在多项指标上全面优于现有方案,甚至在部分任务中超越了参数高达720亿的超大规模基线模型。在盲测排名中,RubiCap-7B稳居榜首,幻觉率最低、事实准确性最高。尤为值得注意的是,仅含30亿参数的RubiCap-3B在若干基准测试中表现反超更大体量模型,印证了高性能密集图像描述能力未必依赖于模型规模膨胀,轻量化路径同样具备强大竞争力。



