





2026 年 3 月 19 日凌晨,小米正式推出 mimo-v2-pro、mimo-v2-omni 和 mimo-v2-tts 三款全新大模型,全面覆盖文本推理、多模态感知与语音合成三大核心能力,所有模型均已面向开发者开放调用。
如果你近期关注 AI 领域动态,或许已注意到一个代号为“Hunter Alpha”的低调模型——它悄然上线全球规模最大的 API 聚合平台 OpenRouter,全程零官方宣传,却在数日内迅速走红,连续多日稳居平台日调用量榜首,累计处理 token 数突破 1T(一万亿)。开发者社区热议不断:这究竟是哪家的神秘力量?有人猜测是 DeepSeek-V4,甚至“龙虾之父”(OpenClaw 框架创始人)也在社交平台公开求证其出处。
谜底于今晨揭晓:正是小米。而此次并非简单认领一款隐藏模型,而是以雷霆之势同步发布三款旗舰级模型——MiMo-V2-Pro、MiMo-V2-Omni、MiMo-V2-TTS,分别对应 AI 的“大脑”、“感官系统(眼+耳)”与“发声器官(嘴)”,共同构建起一个完整、协同、可落地的多模态智能体能力闭环。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
首款:MiMo-V2-Pro,AI 的“思考中枢”
“Hunter Alpha”正是 MiMo-V2-Pro 在内测阶段使用的代号。该旗舰级语言模型总参数量超 1T(一万亿),激活参数达 42B,原生支持最长 1M tokens 上下文长度;采用新一代混合注意力机制,混合比例由上一代的 5:1 显著跃升至 7:1,在维持超大规模参数的同时,实现高吞吐、低延迟的推理表现。
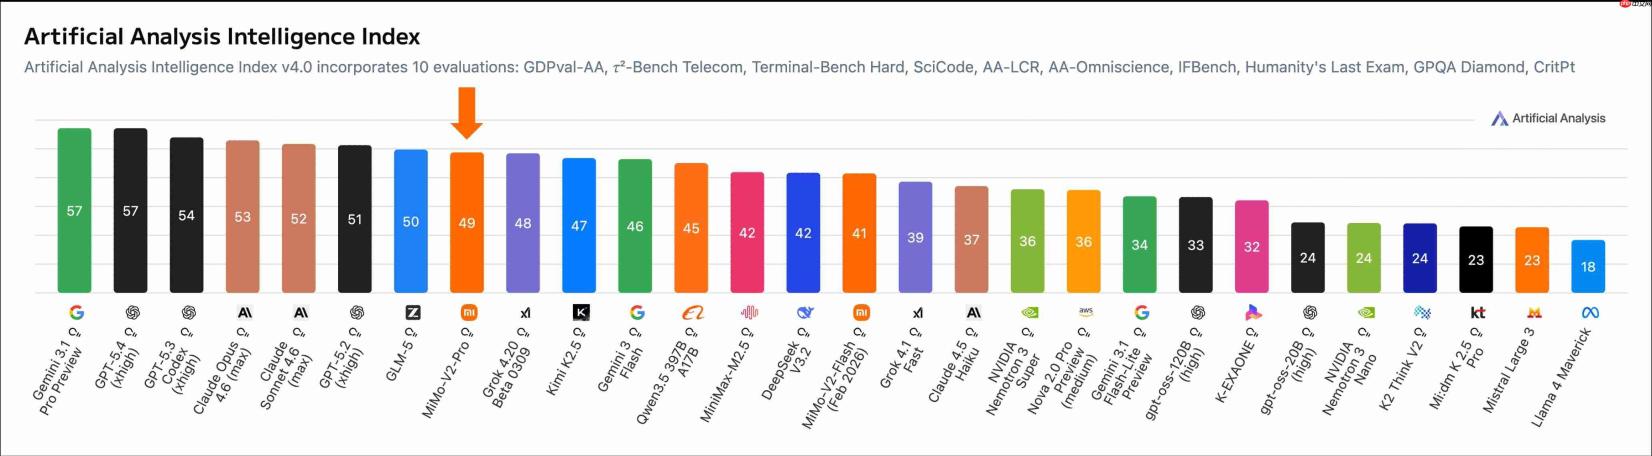
在全球权威大模型综合能力榜单 Artificial Analysis 中,MiMo-V2-Pro 当前排名全球第八、国内第二;在代码专项评测 SWE-bench Verified 中斩获 86.7 分,力压 Claude 4.6 Sonnet;在智能体行为评估 PinchBench 上亦取得 84.0 分,稳居世界前列。
尤为关键的是其商业化策略:API 定价仅为同档位竞品 Claude Opus 4.6 的 20%,大幅降低中小开发者与初创团队的接入门槛——仅需五分之一成本,即可获得接近业界顶流的推理能力。目前 MiMo-V2-Pro 已全面开放 API 接入,支持 1M 上下文,采用阶梯式用量计费模式。
第二款:MiMo-V2-Omni,AI 的“感知中枢”
若说 MiMo-V2-Pro 解决了“如何思考”,那么 MiMo-V2-Omni 则致力于攻克“如何感知”。
这款全模态统一基座模型从架构底层即融合文本、图像、语音三大模态,彻底打破传统模型“重理解、弱执行”的割裂状态。它不止于分别解析图片、音频或视频,更将“感知”与“行动”深度耦合——看得懂,更能立刻动手干。
其早期测试版代号为“Healer Alpha”,同样匿名入驻 OpenRouter,并在 PinchBench 多模态智能体评测中斩获均分第一。正式版本在三大维度实现全面突破:
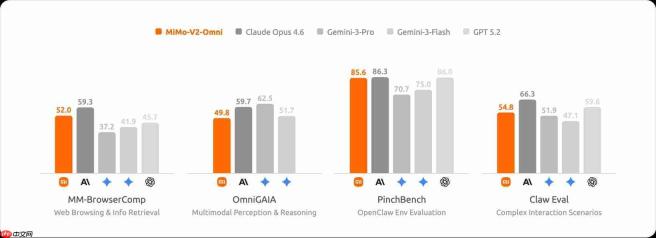
在音频理解方面,支持环境声细粒度分类、多人声源分离、音画跨模态联合推理,并能稳定处理长达 10 小时以上的连续音频流,综合性能超越 Gemini 3 Pro,跻身当前最强音频理解模型行列。
在图像理解方面,于多学科视觉推理与复杂图表解析任务中表现优于 Claude Opus 4.6,逼近 Gemini 3 Pro 水平,可精准解读医学影像、工业图纸、金融数据图谱等高专业性视觉内容。
在智能体执行层面,与 OpenClaw 框架深度协同后,具备类人级浏览器操作能力——涵盖商品筛选、比价分析、客服对话、下单支付等全流程任务;面对网页异常、多标签切换等复杂场景,亦可自主识别并修复,端到端交付结果。在真实数字环境交互基准测试中,其表现与 Gemini 3 Pro 持平。

使用AIsa生成图像与视频。仅需一个API密钥即可调用Gemini 3 Pro Image(图像)和Qwen Wan 2.6(视频)。
MiMo-V2-Omni 已开放 API 接入,支持 256K 上下文,定价为输入 $0.4 / 百万 tokens、输出 $2 / 百万 tokens;同时联合 OpenClaw、OpenCode、KiloCode、Blackbox、Cline 五大主流 Agent 开发框架,提供为期七天的免费接口试用。
第三款:MiMo-V2-TTS,AI 的“表达中枢”
前两型模型解决了“想得清”与“看得明”,MiMo-V2-TTS 的使命,则是让 AI 真正“说得像人”,甚至能唱出动听旋律。
该语音合成模型基于小米自研 Audio Tokenizer 与多码本语音-文本联合建模架构,依托上亿小时高质量语音语料完成预训练,并引入多目标强化学习机制,在语音稳定性与艺术表现力之间达成精妙平衡。
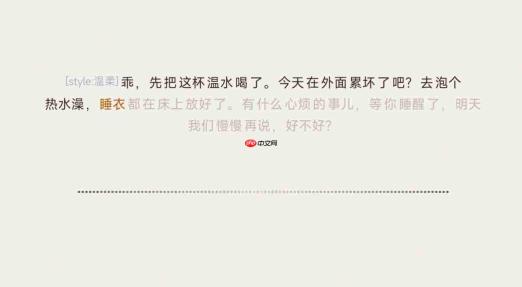
其最大亮点在于多层级情绪可控合成:用户既可通过自然语言指令设定整体语气风格(如“用沉稳坚定的语调朗读”),也可对句中特定片段进行局部情绪微调,实现同一句话内语气起伏、情感转折的自然过渡。例如,“我本来很生气……但听你这么说,我又有点感动了”,整句话的情绪转换流畅自然,毫无违和感。
方言支持方面,MiMo-V2-TTS 已覆盖东北话、四川话、河南话、粤语、台湾腔等多种地域口音,并支持角色化语音演绎;更令人惊喜的是其歌唱合成能力——不仅能准确还原音高与节奏,还可模拟呼吸、颤音、强弱变化等演唱细节,彻底告别“念歌词式”机械唱法。
此外,模型在预训练阶段即学会自动解析文本中的标点符号、语气助词、强调标记等隐含信号,并将其映射为匹配的语音韵律特征,全程无需人工标注或额外提示工程——极大简化了语音功能集成流程,显著提升开发者体验。
小米透露,MiMo-V2-TTS 后续将持续拓展多语种能力,并与 MiMo-V2-Omni 的多模态感知模块深度融合,推动 AI Agent 实现“看得懂世界、理解透世界、讲得好世界”的终极表达闭环。
三位一体,构筑完整智能体能力栈
将三款模型并置审视,小米的战略意图跃然纸上:MiMo-V2-Pro 主导认知推理与任务规划,MiMo-V2-Omni 承担环境感知与物理/数字世界交互,MiMo-V2-TTS 负责拟人化语音输出与情感化交互。三者协同,构成一个真正具备“思考—感知—表达”全链路能力的 AI 智能体技术底座。
目前,全部三款模型已同步上线 Xiaomi miclaw(手机端 AI 智能体)、MiMo Studio、WPS 灵犀办公套件、小米浏览器,并通过 OpenClaw、OpenCode、KiloCode、Blackbox、Cline 五大 Agent 开发框架全面开放,限时一周免费体验。
从一个无名模型悄然登顶 OpenRouter,到今日三大旗舰齐发,小米选择了一条“先凭实力破圈,再以真容亮相”的差异化发布路径。在 AI 军备竞赛白热化的 2026 年,这套组合拳节奏清晰、逻辑严密、落地扎实,展现出极强的技术定力与产品章法。



