





在喧闹的人群中准确捕捉并清晰理解特定个体的语音,人类听觉系统可以毫不费力地完成这一任务;然而,对于传统自动语音识别(asr)模型而言,“鸡尾酒会问题”——即多人同时发言场景下的语音分离与识别——长期以来始终是难以逾越的技术瓶颈。为攻克这一行业级难题,小米近期正式开源了面向工业落地的目标说话人语音识别大模型:cocktailasr-1。
该模型彻底重构了传统ASR的任务范式,引入以参考声纹为导向的目标说话人识别机制。用户仅需提供一段目标人物的参考音频,模型即可通过声纹嵌入技术精准锚定其语音特征,在混叠多说话人的复杂音频流中,专一提取并转录该指定说话人的内容,同时自动抑制其他说话者语音、房间混响及各类环境噪声,从而将原本高难度的语音分离+识别联合任务,简化为高效、鲁棒的目标说话人语音识别流程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
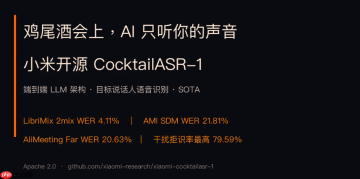
在模型架构层面,CocktailASR-1采用端到端的大语言模型结构,由D2V2音频编码器、Adapter模块与大模型解码器三级串联构成,全部参数统一整合于单一检查点文件中。实际推理时,输入格式为:参考音频 + 1秒静音分隔符 + 待处理的单声道混合音频。该设计赋予模型极强的场景泛化能力,无论面对单人语音还是高密度多人对话,均无需切换模型或调整配置,即可实现“开箱即用”的全流程识别。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
权威基准测试结果充分印证了其卓越性能。在模拟多说话人场景下,模型在LibriMix2mix与LibriSpeechMix2mix数据集上的字错率(WER)分别低至4.11%与2.90%。而在更具挑战性的三说话人混合测试(LibriMix3mix)中,主流竞品模型WER普遍飙升至76%–121%,而CocktailASR-1仍稳定维持在12.29%,展现出显著的代际优势。即便在真实会议录音这类噪声强、重叠多、语速快、设备差异大的复杂场景(如AMI SDM、AliMeeting Far),该模型同样大幅领先现有各类方案。值得一提的是,在标准单人语音识别任务中,其在LibriSpeech、WenetSpeech及CommonVoice-zh等主流中文/英文数据集上亦全面刷新SOTA表现。
除识别精度突破外,该模型在工程实用性和系统可靠性方面还具备两大关键特性。其一,具备优异的负样本拒识能力:当所提供的参考音频对应的人物并未出现在当前音频中时,模型可主动返回空文本,有效避免智能音箱、车载语音助手等终端被非目标用户语音误唤醒。实测显示其在多个负样本测试集上拒识成功率极高。其二,支持思维链(Chain-of-Thought)推理模式:模型可在最终输出前,通过预设标签显式呈现其识别目标说话人的逻辑路径,虽对识别准确率影响微乎其微,却极大增强了系统的可解释性与开发调试效率。
目前,CocktailASR-1已基于Apache 2.0协议在GitHub平台完全开源,部署门槛极低——仅依赖torch、torchaudio、transformers与soundfile等基础库,即可直接从Hugging Face Hub加载模型并快速集成上线。小米此次在语音识别底层范式上的战略升级,标志着该技术正从“广域拾音、全量识别”的旧阶段,加速迈入“定向聚焦、按需提取”的新纪元。



