






前言
今天收到一个导入的任务,要求将excel数据保存到数据库中,不同于普通的导入,这个导入的数据是一个树形结构,如下图:
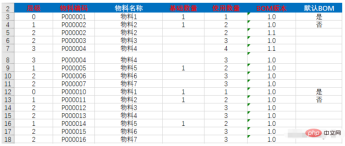
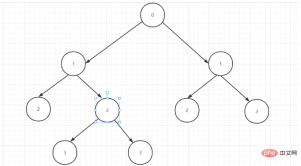
通过观察数据中的层级列我们发现表格数据由2棵树组成,分别是第3,4,5,6,7,8,9,10,11和12,13,14,15,16,17,18,它们由0作树的根节点,1为0的子节点,2为相邻1的子节点,由此得出第一颗树的结构为:
拆分原始数据
1.创建实体类
创建vo接收解析数据,在这里,我们只关心层级属性
	@Excel(name = "层级")
    private String hierarchy;
    @Excel(name = "物料编码")
    private String materialCode;
    @Excel(name = "物料名称")
    private String materialName;
    @Excel(name = "基础数量")
    private BigDecimal materialNum;
    @Excel(name = "使用数量")
    private BigDecimal useAmount;
    @Excel(name = "BOM版本")
    private String version;
    @Excel(name = "默认BOM")
    private String isDefaults;
2.处理数据
将数据源拆分为若干棵树的数据集
代码如下(示例):

Java Development Man
下载
Java开发手册规约集合,基于阿里巴巴Java开发手册(嵩山版)。 涵盖7大维度:编程规约、异常日志、单元测试、安全规约、MySQL数据库、工程结构、设计规约。
/**
     * 将集合对象按指定元素分割存储
     *
     * @param materialVos 原始集合
     * @param s 分割元素(这里是当集合对象层级为0时则分割,也就是树的根节点为0)
     * @return 每棵树的结果集
     */
    private List<list>> subsection(List<matmaterialbomimportvo> materialVos, String s) {
        List<list>> segmentedData = new ArrayList();
        if (materialVos != null) {
            //获取指定元素的数量,判断出最终将拆分为多少段
            List<matmaterialbomimportvo> collect = materialVos.stream().filter(bom -> s.equals(bom.getHierarchy())).collect(Collectors.toList());
            int count = 0;
            for (int i = 0; i  bomImportVo = new ArrayList();
                boolean num = false;
                //遍历数据源
                for (; count <h3>手动设置每棵树每个节点的id以及父id</h3>
<p>代码如下(示例):</p>
<pre class="brush:java;">for (List<matmaterialbomimportvo> segmentedDatum : subsection(materialVos, "0")) {
                //设置id以及父id
                int i = 0;
                for (MatMaterialBomImportVo vo : segmentedDatum) {
                    BeanTrim.beanAttributeValueTrim(vo);
                    vo.setPrimaryKey(i);
                    getParentId(vo, segmentedDatum);
                    i++;
                }
}
/**
     * 设置父id
     *
     * @param vo
     * @param segmentedDatum
     */
    private void getParentId(MatMaterialBomImportVo vo, List<matmaterialbomimportvo> segmentedDatum) {
        for (int j = vo.getPrimaryKey(); j >= 0; j--) {
            if (Integer.parseInt(segmentedDatum.get(j).getHierarchy()) == Integer.parseInt(vo.getHierarchy()) - 1) {
                vo.setForeignKey(segmentedDatum.get(j).getPrimaryKey());
                break;
            }
            if (j == 0) {
                vo.setForeignKey(-1);
            }
        }
    }</matmaterialbomimportvo></matmaterialbomimportvo>
说明:拆分为若干棵树后设置每条数据的虚拟id为自己的索引,每棵树的id互相隔离,
根据表格数据规律得出子节点只可能存在于自己节点以下,以及下一个相同节地以上,根据这个规律设置每个节点的父id
递归封装为树结构
代码如下(示例):
/**
     * 递归遍历为树形结构
     *
     * @param vo 当前处理的元素
     * @param segmentedDatum 每棵树的数据集
     */
    private void treeData(MatMaterialBomImportVo vo, List<matmaterialbomimportvo> segmentedDatum) {
        for (int i = vo.getPrimaryKey(); i  1) {
                    vo.setForeignKey(segmentedDatum.get(i).getPrimaryKey());
                    for (int j = vo.getPrimaryKey(); j > 0; j--) {
                        if (Integer.parseInt(segmentedDatum.get(j).getHierarchy()) == Integer.parseInt(vo.getHierarchy()) - 1) {
                            vo.setForeignKey(segmentedDatum.get(j).getPrimaryKey());
                        }
                    }
                }
                vo.getImportVoList().add(segmentedDatum.get(i + 1));
            }
            if (vs  0; j--) {
                        if (Integer.parseInt(segmentedDatum.get(j).getHierarchy()) == Integer.parseInt(vo.getHierarchy()) - 1) {
                            vo.setForeignKey(segmentedDatum.get(j).getPrimaryKey());
                            break;
                        }
                    }
                }
                break;
            }
        }
        if (vo.getImportVoList() != null && vo.getImportVoList().size() > 0) {
            for (MatMaterialBomImportVo matMaterialBomImportVo : vo.getImportVoList()) {
                treeData(matMaterialBomImportVo, segmentedDatum);
            }
        }
    }</matmaterialbomimportvo>
说明:我这里传进来的vo是没有设置id和父id的,只对数据源做了树拆分处理,因为业务需求,后面并没有使用这套递归的方法组装为树,所以递归代码可能有点误差,仅供参考
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南













